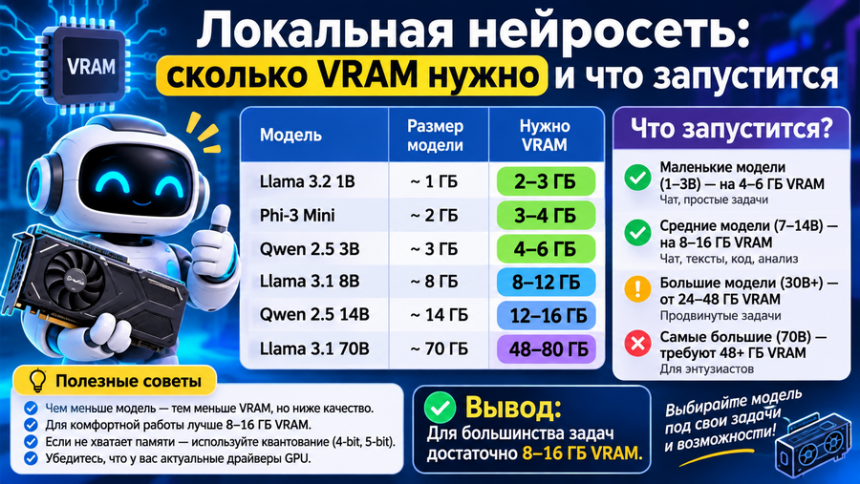
Локальная нейросеть работает на вашем железе, без интернета и без лимитов запросов. Плата — требования к видеопамяти и качество, которое у моделей на 7–8 миллиардов параметров заметно ниже облачных флагманов. Ниже — честная арифметика памяти, сравнение четырёх инструментов и границы, за которые локальный запуск не выходит.
Зачем запускать локально
- Приватность. Документы и переписка не покидают компьютер. Для юристов, врачей и разработчиков это часто единственный допустимый вариант.
- Нет лимитов и цен за токены. После установки запросы бесплатны, количество не ограничено.
- Работа офлайн. В самолёте, на объекте, при слабом интернете.
- Стабильность версии. Модель не обновится и не изменит поведение на следующей неделе.
Обратная сторона: качество, скорость и удобство. Локальная модель на 8B не заменит облачную в сложных рассуждениях, а настройка занимает вечер.
Арифметика памяти: главное, что нужно понять
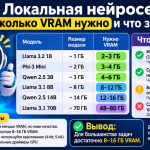
Память под веса считается просто: число параметров × битность ÷ 8. Модель на 7 миллиардов параметров в 16-битном формате занимает около 14 ГБ, в 4-битном — около 3,5–4 ГБ.
К этому добавляются накладные расходы: контекст (KV-кэш), буферы, сама программа. На практике прибавляйте 15–30% к весу модели, а при длинном контексте — больше.
| Размер модели | FP16 | Q8 | Q4 (стандарт) | Подходит для |
|---|---|---|---|---|
| 7–8B | ~14–16 ГБ | ~8–9 ГБ | ~4–5 ГБ | Видеокарта 8 ГБ |
| 13–14B | ~26–28 ГБ | ~14–15 ГБ | ~8–9 ГБ | Видеокарта 12 ГБ |
| 30–34B | ~60–68 ГБ | ~32–36 ГБ | ~19–21 ГБ | Видеокарта 24 ГБ |
| 70B | ~140 ГБ | ~70–75 ГБ | ~40–43 ГБ | Две карты по 24 ГБ или 48 ГБ |
Если памяти не хватает, часть слоёв уходит в оперативную — скорость падает в разы. Поэтому «влезет или нет» решает не процессор, а объём VRAM.
Четыре инструмента
| Инструмент | Платформы | Сложность | Кому подойдёт |
|---|---|---|---|
| Ollama | Windows, macOS, Linux | Низкая: одна команда | Тем, кто хочет быстро и через терминал |
| LM Studio | Windows, macOS, Linux | Низкая: графический интерфейс | Тем, кто не любит командную строку |
| Jan | Windows, macOS, Linux | Низкая | Тем, кому нужен аналог чата с историей |
| llama.cpp | Почти всё, включая Raspberry Pi | Средняя | Тем, кто собирает своё решение |
Ollama: самый короткий путь
Установка занимает минуты. После неё достаточно двух команд: одна скачивает модель, вторая её запускает. Дальше в терминале открывается диалог, а сама программа поднимает локальный API — его можно подключить к своему приложению.
Полезные возможности: список установленных моделей, удаление ненужных, работа через собственный сервер на порту 11434, поддержка формата GGUF.
LM Studio: то же самое мышкой
Графический клиент: поиск моделей по каталогу, ползунок квантования, чат с настройками температуры и системного промпта. Удобно для первого знакомства и для сравнения моделей «в один клик».
Как выбрать модель под свою видеокарту
| VRAM | Модели | Что реально умеет |
|---|---|---|
| 6–8 ГБ | 7–8B в Q4 | Переписать текст, ответить на простой вопрос, суммаризация |
| 12 ГБ | 13–14B в Q4 | Увереннее держит структуру, лучше с кодом и таблицами |
| 16 ГБ | 14B в Q8 или 20–24B в Q4 | Рабочий уровень для документов и анализа |
| 24 ГБ | 30–34B в Q4 | Заметно лучше в рассуждениях, терпимый русский |
| 48 ГБ и больше | 70B в Q4 | Близко к облачным моделям среднего класса |
Скорость: чего ждать
Ориентиры для модели 7–8B в 4-битном квантовании:
- Видеокарта среднего уровня: 40–70 токенов в секунду — быстрее, чем вы читаете.
- Встроенная графика или ноутбук без дискретной карты: 5–12 токенов в секунду — терпимо для коротких ответов.
- Модель 70B на двух картах: 5–15 токенов в секунду; на процессоре — меньше одного, то есть неработоспособно.
Скорость падает при длинном контексте и при одновременных запросах: память под контекст растёт линейно.
Чего локальная модель не умеет
Это самая важная часть, потому что ожидания обычно завышены.
Плохой русский у моделей до 14B. Они понимают вопрос, но отвечают с калькой с английского, путают падежи и термины. Для русскоязычных задач лучше брать модели, специально обученные на русском, либо модели от 30B.
Слабая математика и логика. Модель на 8B уверенно ошибается в многошаговых расчётах. Проверяйте числа калькулятором.
Короткая память. Контекст в 8–32 тысячи токенов — это 20–60 страниц, а не книга. Всё, что дальше, модель не видит.
Нет знаний о свежих событиях. Дата обучения зашита в веса. Без доступа к поиску модель не знает, что случилось после её выпуска.
Галлюцинации никуда не исчезают. Локальность не делает модель точнее — она лишь не отправляет данные в облако.
Локально или облако: сравнение
| Критерий | Локально | Облако |
|---|---|---|
| Стоимость старта | 0, если железо уже есть | 0 |
| Стоимость владения | Электричество, износ железа | Подписка или оплата за токены |
| Приватность | Полная | Зависит от политики сервиса |
| Качество | Среднее | Максимальное |
| Скорость | Зависит от железа | Стабильно высокая |
| Обновления | Вручную | Автоматически |
| Работа офлайн | Да | Нет |
Разумная схема — гибрид: конфиденциальные документы обрабатывать локально, сложные задачи и генерацию изображений отдавать облаку.
Безопасность при установке
- Скачивайте модели из официальных репозиториев, а не с файлопомоек: файл модели — это исполняемые данные, подмена возможна.
- Проверяйте формат: GGUF — стандарт для локального запуска, но происхождение файла важнее формата.
- Не давайте локальному агенту доступ к файловой системе без необходимости.
- Помните, что «локально» не значит «безопасно»: модель может воспроизвести данные из обучающего набора.
Коротко
- Память считают по формуле «параметры × битность ÷ 8» плюс 15–30%.
- 8 ГБ VRAM — это уровень 7–8B в Q4, не больше.
- Ollama и LM Studio закрывают 90% потребностей.
- Локально выигрываете в приватности, проигрываете в качестве.
Частые вопросы
Можно ли запустить нейросеть на компьютере без видеокарты?
Да, на процессоре. Но скорость будет низкой: 3–10 токенов в секунду для моделей 7–8B и меньше одного для крупных. Для коротких ответов терпимо, для работы — нет.
Сколько оперативной памяти нужно?
Если модель помещается в видеопамять, хватает 16 ГБ. Если нет — потребуется столько же оперативной памяти, сколько не хватило VRAM, и скорость упадёт в разы.
Какая локальная модель лучше для русского языка?
Модели от 30B и специально дообученные на русском. Среди компактных вариантов стоит тестировать Qwen и семейства, обученные на многоязычных данных: они держат русский заметно лучше англоцентричных моделей того же размера.
Можно ли запустить нейросеть на телефоне?
Можно, но только компактные модели на 1–4 миллиарда параметров. Они годятся для суммаризации и простых ответов, но не для сложных задач.
Нужен ли интернет после установки?
Нет. Модель скачивается один раз, дальше работает офлайн. Интернет нужен только для поиска в интернете, если вы подключили такой инструмент.
Это законно?
Запуск модели на своём компьютере — да. Условия использования определяет лицензия конкретной модели: одни разрешают коммерческое применение, другие только исследовательское.
Читайте также
- Виды нейросетей — какие архитектуры бывают и чем отличаются.
- Контекстное окно — почему память модели ограничена.
- Чат ГПТ на компьютере — облачный вариант без установки моделей.
- Как обучить нейросеть на своих данных — что делать после запуска.