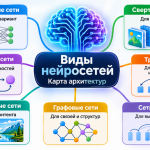
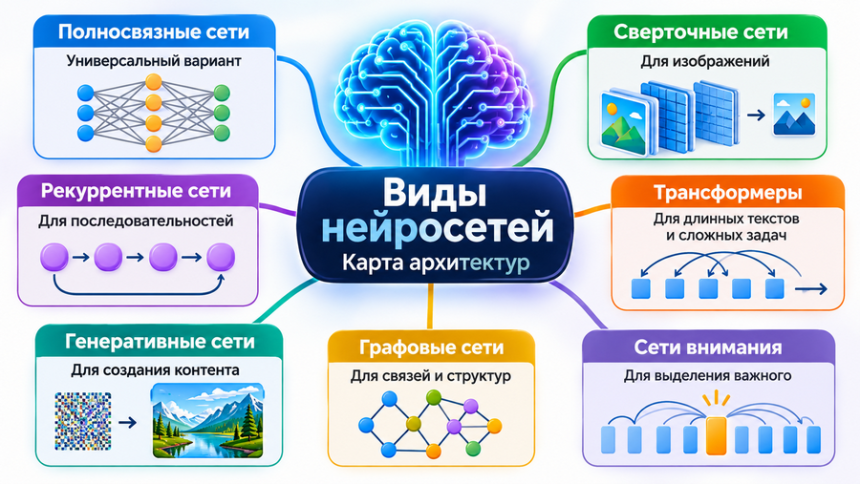
Виды нейросетей различают не по названиям, а по архитектуре: от того, как в модели расположены связи между «нейронами», зависит, что она умеет. Свёрточная сеть хорошо видит, трансформер — читает, диффузионная — рисует. Ниже — карта архитектур с таблицей «задача → модель» и честными ограничениями каждой.
Сначала о путанице: архитектура, модель и продукт
Три вещи, которые постоянно смешивают, хотя они лежат на разных уровнях:
- Архитектура — схема построения сети: полносвязная, свёрточная, рекуррентная, трансформер. Отвечает на вопрос «как устроены связи».
- Модель — конкретная сеть с конкретными весами: GPT-5, Llama, Qwen, Stable Diffusion. Отвечает на вопрос «что именно обучено».
- Продукт — интерфейс, в котором модель доступна: ChatGPT, наш чат, мобильное приложение. Отвечает на вопрос «как этим пользоваться».
Поэтому фраза «виды нейросетей» означает виды архитектур, а не список сайтов. И одна архитектура может лежать в основе десятков моделей: почти все современные текстовые модели — трансформеры, но различаются данными, размером и обучением.
Четыре базовых семейства
1. Полносвязные сети (MLP, перцептрон)
Самый старый тип: нейроны собраны в слои, каждый связан со всеми нейронами предыдущего и следующего. Такая сеть умеет находить зависимости в табличных данных: предсказать отток клиента, оценить стоимость квартиры по параметрам, определить риск по медицинским показателям.
Сильная сторона — простота и скорость на небольших таблицах. Слабая — изображение 1000×1000 пикселей превращается в миллион входов, и сеть теряет смысл картинки: для неё это просто набор чисел без соседства.
2. Свёрточные сети (CNN)
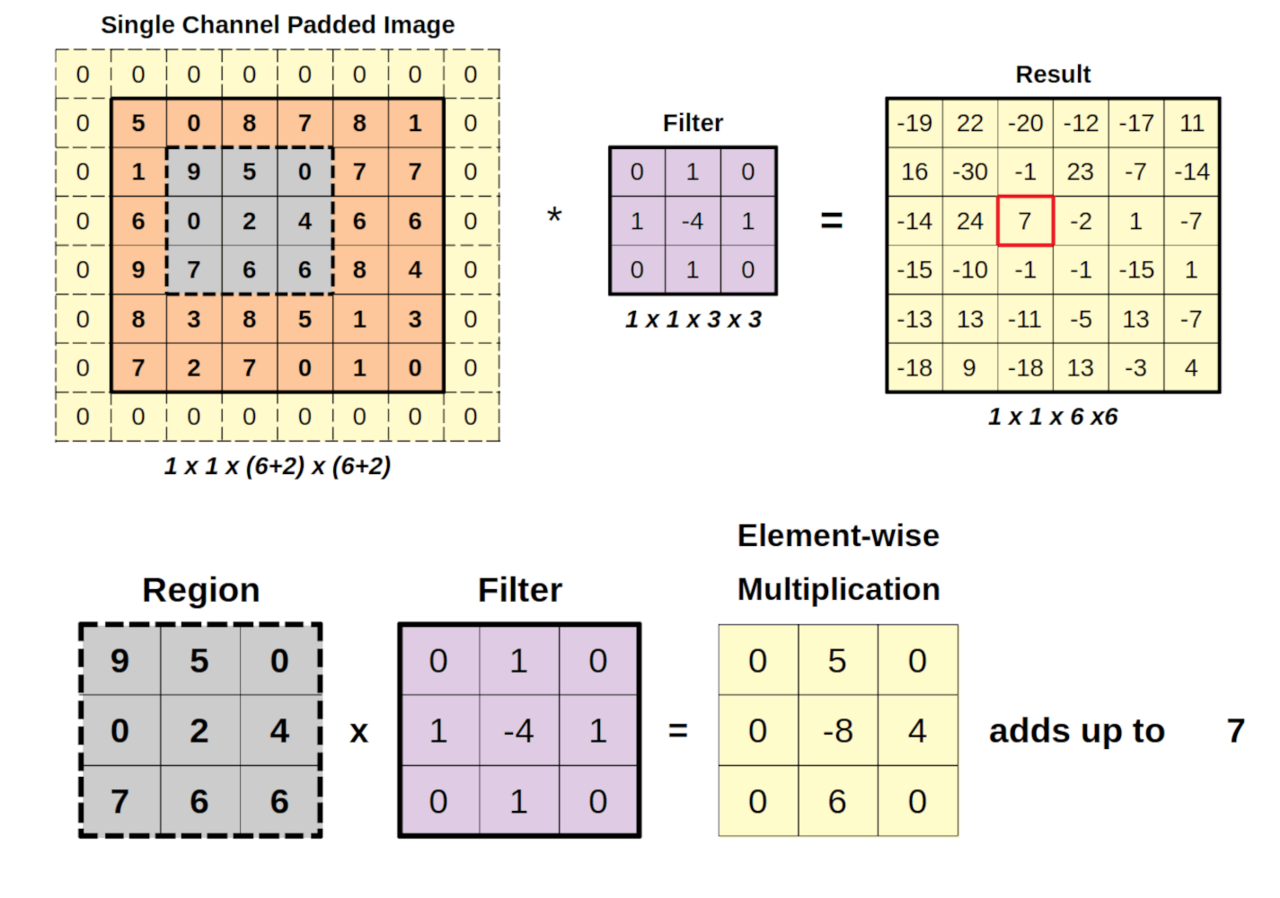
Идея 1989 года, доведённая до прорыва в 2012-м: вместо полной связи используется скользящее «окно» (свёртка), которое ищет одинаковые признаки в разных частях изображения. Сеть учится распознавать края, затем формы, затем объекты.
Где применяется: распознавание объектов и лиц, медицинская диагностика по снимкам, контроль качества на производстве, обработка спутниковых изображений. До 2021 года CNN были стандартом и в распознавании речи.
Предел: свёртка плохо работает с длинными последовательностями и с данными, где важен дальний контекст — например, со смыслом абзаца текста.
3. Рекуррентные сети (RNN, LSTM, GRU)
Сети с «памятью»: обрабатывают данные по одному элементу и передают состояние дальше. LSTM (1997) научилась удерживать информацию на сотни шагов — это позволило делать машинный перевод и распознавание речи до эпохи трансформеров.
Сейчас в чистом виде почти не используются: обучаются медленно и плохо терпят длинные тексты. Но их идеи живут в потоковых задачах — предсказание рядов, обработка сигналов с датчиков.
4. Трансформеры
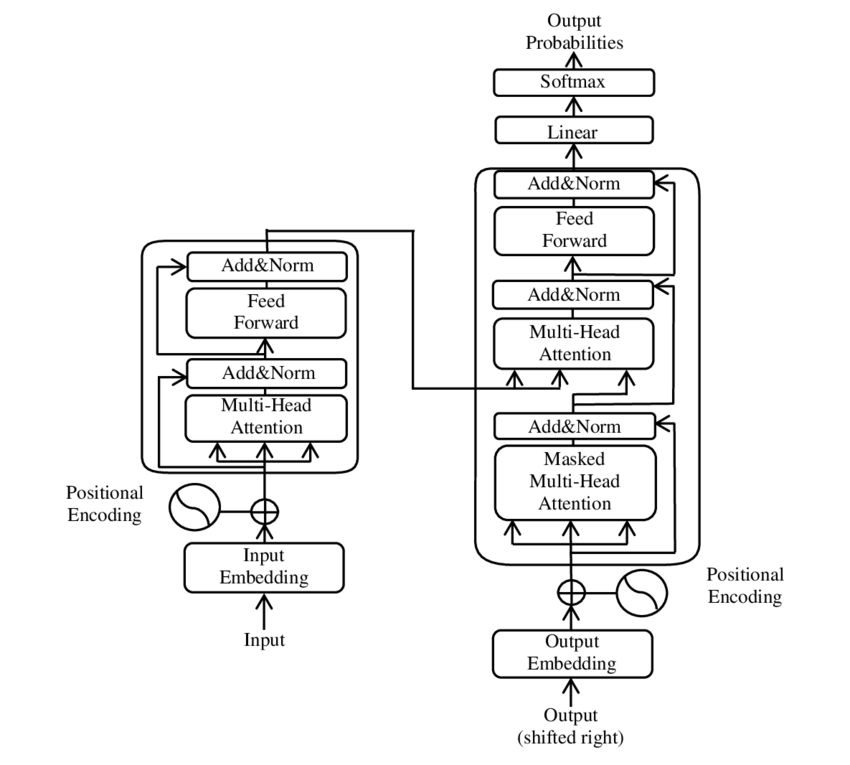
Архитектура 2017 года, которая изменила всё. Механизм внимания позволяет модели смотреть на все части текста сразу и взвешивать, что с чем связано. Именно на трансформерах построены GPT, Claude, Gemini, Llama, Qwen и DeepSeek.
Ключевое свойство — масштабируемость: качество предсказуемо растёт с увеличением данных и параметров. Это и стало топливом нынешнего этапа.
Виды нейросетей: полная таблица
Двенадцать типов, которые встречаются чаще всего. В колонке «предел» — то, из-за чего модель этого типа не подходит для соседней задачи.
| Тип | Что делает | Пример применения | Предел |
|---|---|---|---|
| MLP (полносвязная) | Ищет зависимости в числах | Скоринг, прогноз оттока, оценка стоимости | Не видит структуру изображений и текста |
| CNN (свёрточная) | Распознаёт образы | Медицинские снимки, дефекты на конвейере | Слаба на длинных последовательностях |
| RNN / LSTM | Работает с рядами и сигналами | Датчики, прогноз нагрузки, аудио | Медленное обучение, забывает далёкое прошлое |
| Трансформер | Понимает и генерирует текст | Чаты, перевод, код, анализ документов | Дорогой инференс, склонен к галлюцинациям |
| Автокодировщик | Сжимает и восстанавливает данные | Поиск аномалий, очистка шума, сжатие | Не генерирует новое, только похожее |
| VAE (вариационный) | Учится распределению данных | Генерация лиц, сэмплирование молекул | Результат размытый по сравнению с диффузией |
| GAN (состязательная) | Генерирует, соревнуясь с критиком | Фотореалистичные лица, апскейл, стилизация | Нестабильное обучение, артефакты |
| Диффузионная | Строит изображение из шума | Midjourney, Stable Diffusion, Sora | Медленная генерация, дорогая тренировка |
| Графовая (GNN) | Работает со связями между объектами | Соцсети, логистика, молекулы, антифрод | Требует хорошо построенного графа |
| Рекомендательная | Предсказывает выбор пользователя | Ленты, маркетплейсы, музыка | Склонна к «пузырю» однотипного контента |
| Обучение с подкреплением | Учится через награду | Игры, роботы, настройка моделей (RLHF) | Нужна среда и продуманная награда |
| Мультимодальная | Связывает текст, изображение, звук | Описание фото, поиск по картинке, озвучка | Ошибки переносятся между модальностями |
Три способа обучения — и почему это важнее архитектуры
Две одинаковые сети с разным обучением дадут разный результат. Способы три:
| Подход | Что нужно | Пример | Когда выбирать |
|---|---|---|---|
| С учителем | Размеченные пары «вход → правильный ответ» | Классификация писем, распознавание номеров | Есть исторические данные с ответами |
| Без учителя | Только данные, без разметки | Кластеризация клиентов, поиск аномалий | Разметки нет или она дорогая |
| С подкреплением | Среда и функция награды | Игровые агенты, RLHF для чатов | Важен результат действий, а не ответ |
Как выбрать тип под задачу
Простое правило: сначала определяется тип данных, потом архитектура.
- Таблица с числами → градиентный бустинг или MLP. Часто бустинг обходит нейросеть и обучается за минуты.
- Изображения → CNN для распознавания, диффузия для генерации.
- Текст, документы, диалог → трансформер.
- Ряд с датчиков → LSTM или специализированные модели временных рядов.
- Связи между объектами → графовая сеть.
- Нужен готовый результат «здесь и сейчас» → не обучать, а взять готовую модель через чат.
Последний пункт экономит больше всего денег. Обучение имеет смысл, когда данных много, задача повторяется тысячи раз в сутки и есть чем платить за инфраструктуру. В остальных случаях готовая модель в чате решает задачу быстрее.
Что из этого доступно в обычном чате
Текстовый чат — это трансформер с диалоговой надстройкой. Он хорошо справляется с задачами, где ответ выражается словами: разобрать документ, составить план, переписать текст, объяснить термин, придумать структуру таблицы.
Чего он не делает: не обучается на ваших данных сам по себе, не считает смету по чертежу с точностью до миллиметра и не гарантирует факты. Если модель ошиблась в факте — это не «сбой вида нейросети», а свойство генеративного подхода: она предсказывает правдоподобный текст, а не проверяет истину.
Практический вывод: вид нейросети определяет класс задач, но не отменяет проверки результата. Об этом стоит помнить, когда читаете, что «нейросеть заменит» ту или иную профессию.
Коротко
- Видов нейросетей много, но базовых семейств четыре: полносвязные, свёрточные, рекуррентные, трансформеры.
- Генерация изображений и видео — отдельная ветка: GAN, VAE, диффузия.
- Архитектура выбирается под тип данных, а не под моду.
- Для 9 из 10 задач бизнеса не нужно обучать модель — достаточно готовой и правильно составленного запроса.
Частые вопросы
Нейросеть и искусственный интеллект — это одно и то же?
Нет. Искусственный интеллект — общее название области. Нейросеть — один из инструментов этой области, самый популярный сегодня, но не единственный: есть символьные системы, экспертные системы, алгоритмы поиска.
Сколько существует видов нейросетей?
Десятки архитектур и сотни их вариантов. На практике в 95% проектов встречаются пять-шесть: трансформеры, CNN, MLP, диффузионные модели и рекомендательные системы.
Какая нейросеть самая мощная?
Зависит от задачи. В генерации текста лидируют большие трансформеры, в распознавании изображений — специализированные CNN и визуальные трансформеры, в табличных данных нейросеть часто проигрывает градиентному бустингу.
Можно ли обучить нейросеть без программирования?
Частично. Настроить готовую модель на своих данных можно через интерфейсы вроде Ollama или облачных платформ, но подготовка данных и проверка качества всё равно требуют понимания процесса.
Почему нейросеть ошибается?
Она воспроизводит закономерности обучающих данных, а не проверяет факты. Если в данных был перекос или пробел, модель уверенно выдаст неверный ответ — это называется галлюцинацией.
Что лучше: нейросеть или обычный алгоритм?
Обычный алгоритм лучше там, где есть точные правила: расчёт зарплаты, сортировка, бухгалтерия. Нейросеть выигрывает там, где правила трудно сформулировать: распознать речь, понять текст, описать изображение.
Читайте также
- История искусственного интеллекта: от Тьюринга до GPT-6.1 — как эти архитектуры появлялись.
- Контекстное окно нейросети — почему объём «памяти» модели ограничен.
- Нейросеть для картинок — как работает генерация изображений на практике.
- Как отличить текст, написанный нейросетью — признаки генерации.