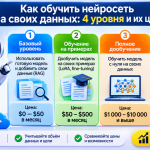
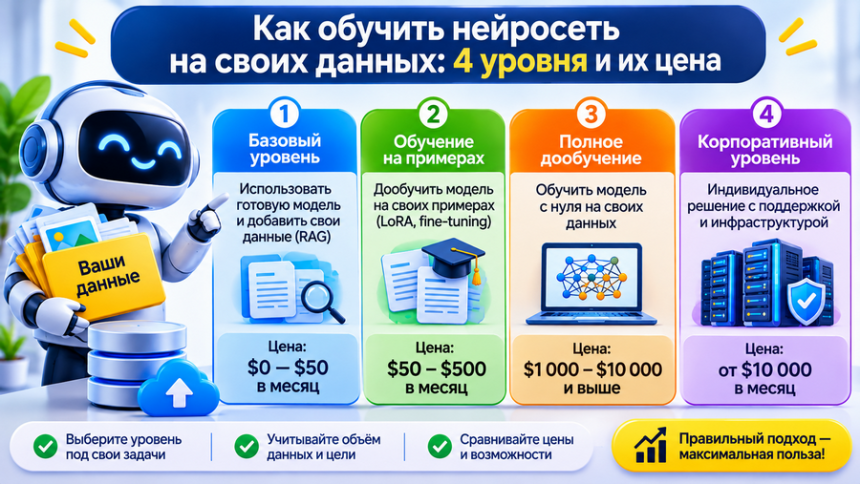
Обучить нейросеть на своих данных можно четырьмя способами, и они различаются по цене в тысячи раз: от бесплатного промпта до предобучения за миллионы долларов. Большинство задач решается на первых двух уровнях. Ниже — что именно происходит на каждом, сколько это стоит и где проходит граница здравого смысла.
Сначала главное: «обучить» понимают по-разному
Когда говорят «хочу обучить нейросеть на наших документах», обычно имеют в виду одно из четырёх:
- «Хочу, чтобы она знала содержание наших файлов» — это база знаний, а не обучение.
- «Хочу, чтобы она отвечала в нашем стиле» — это настройка инструкций или дообучение.
- «Хочу, чтобы она решала нашу узкую задачу» — дообучение.
- «Хочу свою модель с нуля» — предобучение.
Выбор уровня определяется не амбициями, а объёмом данных и частотой задачи. Если задача возникает десять раз в месяц — обучать модель экономически бессмысленно.
Уровень 0. Промпт и контекст: бесплатно, минуты
Модель получает инструкции и данные прямо в запросе. Ничего не обучается, веса не меняются — но результат может быть достаточным.
Что даёт: роль («ты редактор технических текстов»), формат ответа («таблица из трёх колонок»), примеры («вот два образца нашего тона»), ограничения («не используй слова «инновационный» и «экосистема»).
Когда хватает: разовые задачи, шаблонные тексты, разбор документов до 100–200 страниц, если модель поддерживает длинный контекст.
Где не работает: когда нужно знание закрытой базы на тысячу документов и когда ответ должен быть одинаково точным каждый раз.
Уровень 1. База знаний и RAG: дни, десятки долларов
RAG (retrieval-augmented generation) — это не обучение модели, а поиск по вашим документам перед генерацией ответа. Схема простая:
- Документы режутся на фрагменты по 300–800 токенов.
- Каждый фрагмент превращается в вектор (эмбеддинг) и складывается в векторную базу.
- На вопрос система ищет 3–10 ближайших фрагментов.
- Модель отвечает, опираясь на найденное, и может ссылаться на источник.
Что нужно: документы в машиночитаемом виде, сервис эмбеддингов, векторное хранилище (подойдёт и бесплатное локальное), 1–2 дня на сборку.
Сильная сторона: знания обновляются мгновенно — заменили файл, и ответы изменились. Никакого переобучения.
Слабое место: качество зависит от нарезки. Слишком крупные фрагменты размывают ответ, слишком мелкие теряют смысл. Отдельная проблема — документы с таблицами и сканы без текстового слоя.
Уровень 2. Дообучение: недели, сотни — тысячи долларов
Дообучение (fine-tuning) меняет веса модели на ваших примерах. Рабочий стандарт сегодня — LoRA и её варианты: обучается не вся модель, а небольшие надстройки, от 0,1 до 1% параметров. Поэтому процесс идёт на одной видеокарте, а не на кластере.
Что решает: устойчивый стиль и формат, специфическая терминология, классификация по вашей таксономии, извлечение полей из документов одного типа.
Что не решает: добавление новых фактов. Модель, дообученная на прайс-листе, не станет надёжным справочником цен — для этого нужен RAG. Дообучение учит поведению, а не хранению фактов.
Что нужно: 500–5 000 качественных пар «запрос → идеальный ответ». Именно качественных: тысяча случайных примеров даст худший результат, чем триста аккуратных.
| Параметр | Реалистичная оценка |
|---|---|
| Данные | 500–5 000 примеров, размеченных вручную |
| Время на подготовку | 1–3 недели (это дольше, чем само обучение) |
| Обучение | от 1–2 часов на потребительской видеокарте до суток в облаке |
| Стоимость | от $10–50 за облачный запуск LoRA до $500–2 000 с подготовкой данных |
| Проверка | отдельный набор примеров, которых модель не видела |
Главный риск — переобучение: модель заучивает примеры и начинает хуже справляться с обычными задачами. Поэтому в обучение всегда добавляют часть общих данных, а результат сравнивают с исходной моделью на контрольном наборе.
Уровень 3. Обучение с нуля: миллионы долларов
Предобучение — это когда модель учат языку с нуля на триллионах токенов. Так появляются базовые модели, которые потом дообучают все остальные.
Порядок цифр: обучение модели уровня GPT-3 оценивалось в несколько миллионов долларов вычислительных затрат, фронтирные модели 2026 года — в сотни миллионов. Плюс эксперименты, которые не дали результата, и команда исследователей.
Когда имеет смысл: у вас есть уникальный корпус, которого нет ни у кого, и задача требует принципиально иного поведения — например, модель для редкого языка или для специфических научных данных.
Когда не имеет: почти всегда. Открытые модели (Llama, Qwen, DeepSeek, gpt-oss) уже обучены лучше, чем получится у команды с бюджетом в тысячу раз меньше.
Сравнение уровней
| Промпт | RAG | Дообучение | С нуля | |
|---|---|---|---|---|
| Данные | не нужны | документы | 500–5 000 пар | триллионы токенов |
| Время | минуты | дни | недели | месяцы |
| Деньги | 0 | десятки $ | сотни–тысячи $ | миллионы $ |
| Добавляет знания | частично | да | нет | да |
| Меняет стиль | да | слабо | да | да |
| Обновляется | мгновенно | мгновенно | переобучением | переобучением |
Сколько данных нужно на самом деле
Ориентиры, проверенные практикой:
- Классификация на 5–10 категорий: 100–300 примеров на категорию.
- Извлечение полей из документов: 200–500 документов с эталонным разбором.
- Стиль и тон: 300–1 000 текстов, написанных человеком в нужной манере.
- Диалоговый ассистент: 1 000–5 000 пар «вопрос → ответ», включая отказы и уточнения.
- Своя модель языка: от сотен миллионов токенов, и это только начало.
Важнее объёма — разнообразие. Если все примеры написаны одним человеком об одном продукте, модель выучит этого человека, а не задачу.
Чек-лист подготовки датасета
- Соберите реальные запросы пользователей, а не придуманные — они отличаются сильнее, чем кажется.
- Уберите дубликаты и противоречия: два разных ответа на один вопрос учат модель неуверенности.
- Добавьте негативные примеры: когда ассистент должен отказаться или попросить уточнение.
- Разделите данные на обучение и проверку заранее, до первого запуска.
- Проверьте права: персональные данные, коммерческая тайна, лицензии на тексты.
- Зафиксируйте версию датасета — иначе невозможно понять, почему результат изменился.
Три ошибки, которые встречаются чаще всего
1. Обучать вместо того, чтобы дать контекст. Половина проектов «дообучения» закрывается правильным RAG за два дня.
2. Ждать, что модель запомнит факты. Дообучение на прайсах и регламентах даёт эффект ровно до первого изменения документа.
3. Оценивать «на глаз». Без контрольного набора невозможно отличить улучшение от эффекта новизны. Сравнение должно быть слепым: две модели, одинаковые вопросы, оценка без знания, где чей ответ.
Правовая сторона
Если в данных есть персональные сведения, обучение требует основания по закону о персональных данных — и это касается даже тестовых прогонов. Тексты и изображения из интернета не становятся вашими от того, что лежат в открытом доступе: лицензия важнее доступности. Для внутренних задач безопаснее обезличивать данные до обучения.
Коротко
- Сначала промпт, потом база знаний, только затем дообучение.
- Дообучение меняет стиль и формат, но не добавляет знаний.
- Качественные 500 примеров лучше случайных 5 000.
- Обучение с нуля оправдано в исключительных случаях.
Частые вопросы
Можно ли обучить нейросеть на своих данных бесплатно?
Частично. Промпт с примерами и локальная база знаний обходятся без платежей за обучение. Дообучение небольшой LoRA можно провести на своей видеокарте — расходы будут только на электричество и время.
Сколько данных нужно для дообучения?
Рабочий минимум — 500 качественных пар «запрос → ответ». Для узкой классификации иногда хватает 100–300 примеров на категорию.
Чем дообучение отличается от RAG?
RAG подкладывает нужные фрагменты документов в запрос и обновляется мгновенно. Дообучение меняет саму модель и учит её поведению: стилю, формату, терминологии.
Можно ли обучить нейросеть на переписке и получить клона собеседника?
Получится имитация манеры, а не человек. Модель воспроизведёт типичные фразы, но не получит памяти о событиях и не будет знать контекста, которого нет в переписке.
Портится ли модель после дообучения?
Может. Это называется катастрофическим забыванием: модель теряет часть общих навыков. Поэтому в обучающий набор добавляют общие данные, а результат сравнивают с исходной версией.
Что дешевле: обучить модель или пользоваться готовой?
Почти всегда готовая дешевле. Обучение окупается при высокой частоте однотипных задач, строгих требованиях к формату или работе с закрытыми данными, которые нельзя отправлять в облако.
Читайте также
- Виды нейросетей и где их применяют — какие архитектуры вообще существуют.
- Контекстное окно нейросети — сколько данных влезает в один запрос.
- Промпты для бизнеса — 20 формулировок, которые заменяют обучение.
- История искусственного интеллекта — как менялись подходы к обучению.