Детектор ИИ-текста выглядит как измерительный прибор: полоска, проценты, вердикт. На деле это оценка вероятности по статистике слов — и она ошибается регулярно, в обе стороны.
Разберём, как устроена проверка, почему честный автор получает 90 % «сгенерировано», и что делать, если такой вердикт прилетел вам.
Как детектор «видит» нейросеть
Модели не оставляют метки в тексте (кроме редких случаев с водяными знаками, которые стираются первой же правкой). Поэтому детекторы считают косвенные признаки.
Предсказуемость слов
Основная метрика — насколько легко предсказать каждое следующее слово. Языковая модель выбирает вероятные слова, и её текст в среднем «гладкий». Человеческий — с неожиданными поворотами, разговорными вставками, ошибками ритма. Отсюда и название метрики — перплексия.
Ровность предложений
Люди пишут неровно: короткая фраза, потом длинная, потом обрывок. Модель держит средний ритм. Детектор измеряет разброс длины предложений и «всплески» — резкие смены темы, которых у машинного текста меньше.
Шаблонные связки
«Важно отметить», «в современном мире», «данный подход позволяет», «не только… но и». Это не приговор, но набор таких конструкций повышает оценку.
Откуда берётся процент
Это не «доля текста, написанного ИИ». Это уверенность классификатора в своей гипотезе. Текст на 300 слов может получить 98 % — при том что классификатор просто уверенно ошибся.
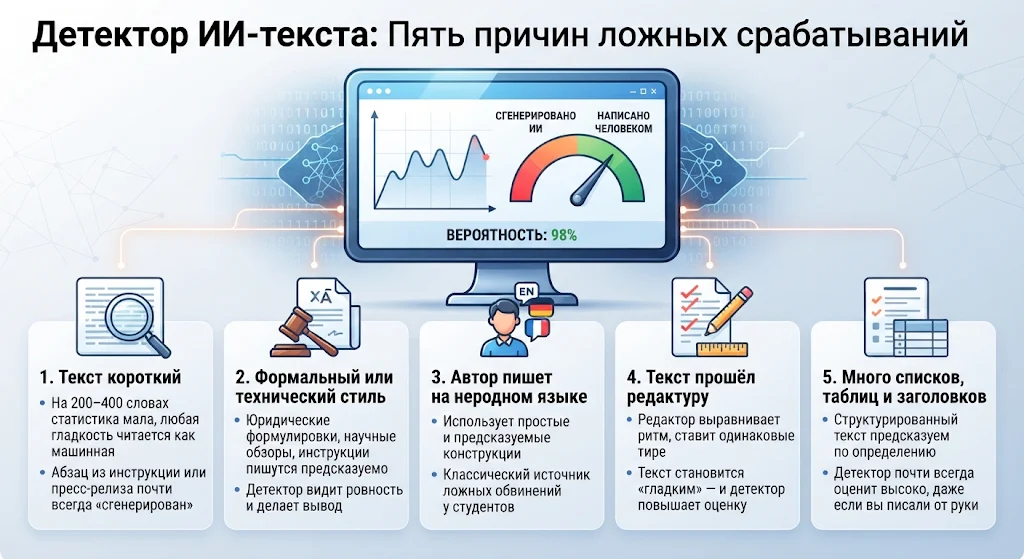
Пять причин ложных срабатываний
1. Текст короткий
На 200–400 словах статистики мало, и любая гладкость читается как машинная. Абзац из инструкции или пресс-релиза почти всегда «сгенерирован» по версии детектора.
2. Формальный или технический стиль
Юридические формулировки, научные обзоры, инструкции и описания процессов пишутся предсказуемо — так требует жанр. Детектор видит ровность и делает вывод.
3. Автор пишет на неродном языке
Человек, пишущий по-английски как на втором языке, выбирает простые и предсказуемые конструкции. Это классический источник ложных обвинений у студентов.
4. Текст прошёл редактуру
Редактор выравнивает ритм, убирает лишнее, ставит одинаковые тире. После такой правки текст становится «гладким» — и детектор повышает оценку. Своя же вычитка может «сделать» вас нейросетью.
5. Много списков, таблиц и заголовков
Структурированный текст предсказуем по определению. Чек-лист, инструкция, разбор по пунктам — детектор почти всегда оценит высоко, даже если вы писали его от руки.
| Что проверяет детектор | Что видит человек |
|---|---|
| Предсказуемость слов | Профессиональный жаргон, устойчивые формулы |
| Ровность ритма | Выправленный редактором текст |
| Отсутствие разговорных вставок | Официальный жанр, инструкция, регламент |
| Повторяющиеся связки | Привычка автора, шаблон рубрики |
| Единый стиль | Хорошая редактура и корректура |
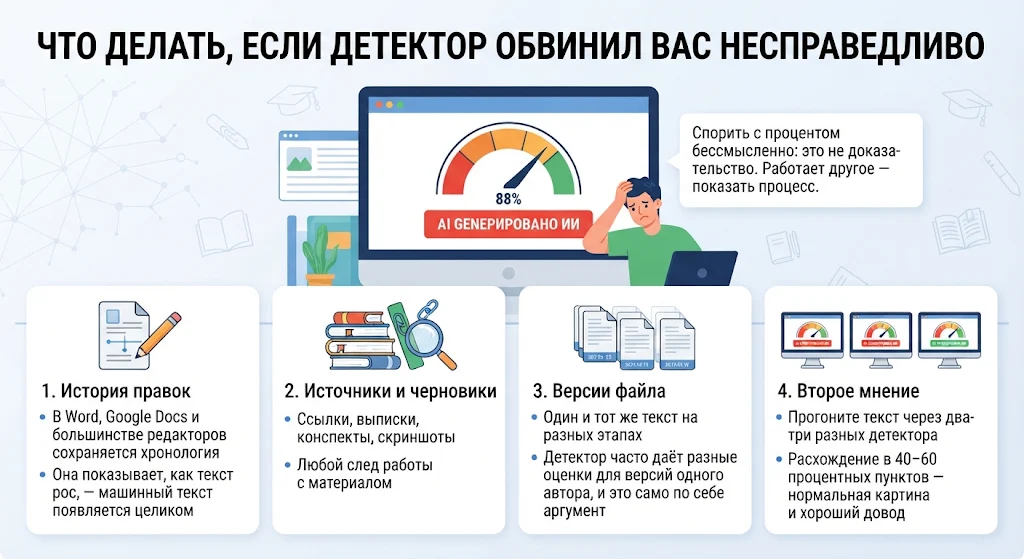
Что делать, если детектор обвинил вас несправедливо
Спорить с процентом бессмысленно: это не доказательство. Работает другое — показать процесс.
- История правок. В Word, Google Docs и большинстве редакторов сохраняется хронология. Она показывает, как текст рос, — машинный текст появляется целиком.
- Источники и черновики. Ссылки, выписки, конспекты, скриншоты — любой след работы с материалом.
- Версии файла. Один и тот же текст на разных этапах: детектор часто даёт разные оценки для версий одного автора, и это само по себе аргумент.
- Второе мнение. Прогоните текст через два-три разных детектора: расхождение в 40–60 процентных пунктов — нормальная картина и хороший довод.
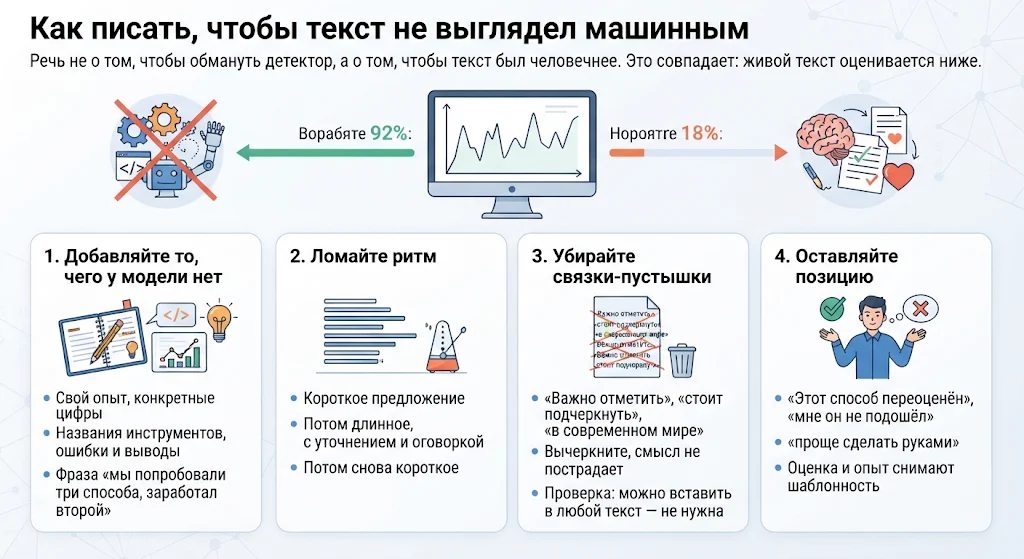
Как писать, чтобы текст не выглядел машинным
Речь не о том, чтобы обмануть детектор, а о том, чтобы текст был человечнее. Это совпадает: живой текст оценивается ниже.
Добавляйте то, чего у модели нет
Свой опыт, конкретные цифры, названия инструментов, ошибки и выводы. Одна фраза «мы попробовали три способа, заработал второй» делает текст непохожим на генерацию.
Ломайте ритм
Короткое предложение. Потом длинное, с уточнением и оговоркой. Потом снова короткое. Модель так не пишет — и детектор это замечает.
Убирайте связки-пустышки
«Важно отметить», «стоит подчеркнуть», «в современном мире» — вычеркните, смысл не пострадает. Проверка простая: если фразу можно вставить в любой текст, она не нужна.
Оставляйте позицию
«Этот способ переоценён», «мне он не подошёл», «проще сделать руками» — оценка и опыт снимают шаблонность сильнее, чем синонимы.
Что детекторы значат юридически и организационно
Почти ничего. Ни один детектор не даёт заключения, которое можно предъявить как доказательство: производители сами оговаривают погрешность. В вузах и редакциях вердикт — повод для разговора, а не приговор; в спорной ситуации решает человек, а не процент.
Отдельно про SEO: поисковики не наказывают за использование ИИ как таковое. Они оценивают пользу, уникальность и точность. Текст, написанный моделью и проверенный человеком, ранжируется нормально; текст без фактов не спасёт никакая «человечность».
Практический минимум
- Пишите черновик сами или правьте машинный настолько, чтобы могли объяснить каждое утверждение.
- Добавьте минимум три конкретных факта, которых нет в общих источниках: цифры, инструменты, сроки.
- Проверьте текст двумя детекторами и не расстраивайтесь от разброса — он и есть доказательство приблизительности метода.
- Храните историю правок: это единственный надёжный аргумент в споре.
Если нужно быстро привести черновик в человеческий вид — уберите связки, разбейте ритм, добавьте конкретику. В нашем чате это делается в диалоге: попросите «убрать общие фразы, добавить конкретные детали из этого списка, не менять смысл» — GPT-5.6 и DeepSeek V4 дают аккуратный результат, если перечислить, что именно считать лишним.
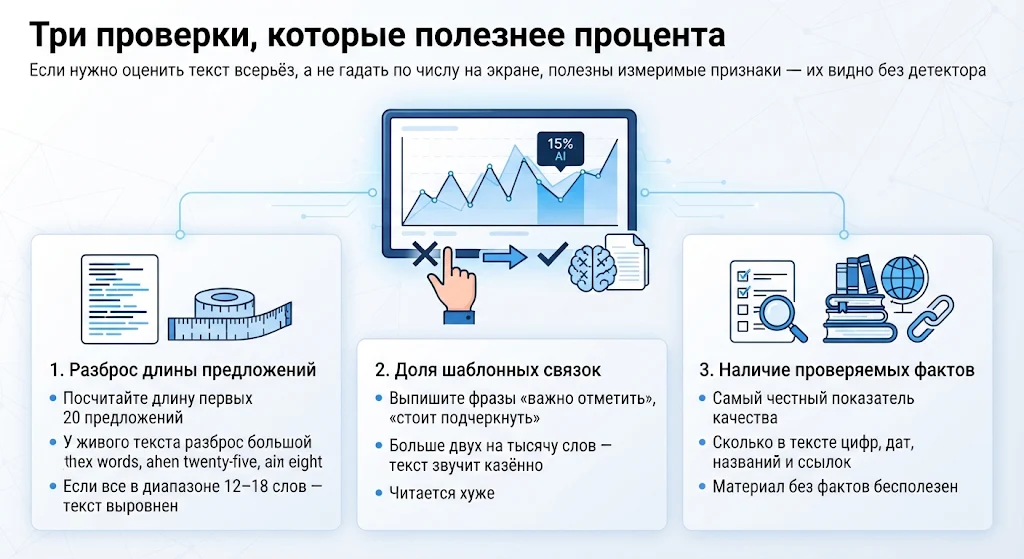
Три проверки, которые полезнее процента
Если нужно оценить текст всерьёз, а не гадать по числу на экране, полезны измеримые признаки — их видно без детектора.
1. Разброс длины предложений
Посчитайте длину первых 20 предложений. У живого текста разброс большой: три слова, потом двадцать пять, потом восемь. Если все предложения в диапазоне 12–18 слов — текст выровнен, и неважно, кто его выровнял.
2. Доля шаблонных связок
Выпишите фразы «важно отметить», «стоит подчеркнуть», «в современном мире», «данный подход». Больше двух на тысячу слов — текст звучит казённо. Это не приговор автору, но читается хуже.
3. Наличие проверяемых фактов
Самый честный показатель качества: сколько в тексте цифр, дат, названий и ссылок, которые можно проверить. Материал без фактов бесполезен независимо от того, кто его написал.
Как устроены формулировки, которые детектор считает «слишком гладкими», разобрано в статье о промптах для копирайтинга. Про учебные тексты и требования преподавателей — материал как учителя используют ChatGPT, а про школьные сочинения — нейросеть для сочинения.
Частые вопросы
Детектор ИИ показывает 100 % — это точно сгенерировано?
Нет. Высокая оценка означает лишь, что текст предсказуем по статистике. Короткие, формальные и выправленные редактором тексты получают высокие оценки регулярно.
Можно ли «обмануть» детектор?
Полностью — нет, и цель другая. Правки вроде замены синонимов дают нестабильный результат: оценка скачет от прогона к прогону. Работает добавление фактов и живой ритм, а не маскировка.
Почему один и тот же текст получает разные оценки?
Классификаторы разные, обучались на разных данных и по-разному считают предсказуемость. Разброс в десятки процентов — норма, а не сбой.
Наказывают ли поисковики за ИИ-текст?
За сам факт — нет. За отсутствие пользы и точности — да, как и любой слабый текст. Проверяются качество, уникальность и соответствие запросу.
Стоит ли указывать, что текст написан с ИИ?
Зависит от площадки. В научных и учебных работах — почти всегда да, это требование. В статьях и блогах достаточно, чтобы материал был проверен и точен.
Как быстро снизить «машинность» текста?
Три действия: убрать связки-пустышки, выровнять ритм вручную (чередовать длину), добавить два-три конкретных факта из своей практики. Обычно этого достаточно.