Соблазн понятный: попросить нейросеть «дай ключевые слова по теме» и получить готовое семантическое ядро. На практике так не работает — и важно понимать почему, чтобы не потратить неделю на список, который ничему не соответствует.
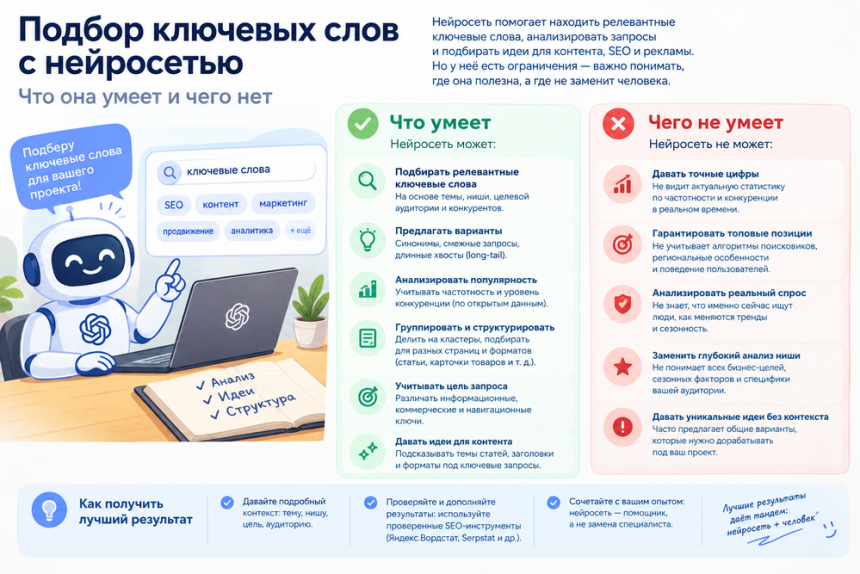
Главная проблема: модель не знает частотности
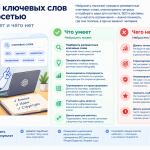
Нейросеть не имеет доступа к статистике поиска. Она генерирует правдоподобные формулировки, но не знает, сколько людей их вводят. Разница принципиальная:
| Что модель даёт | Что нужно для SEO |
|---|---|
| Логичные формулировки | Реальная частотность |
| Похожие по смыслу фразы | Разбивка по регионам и устройствам |
| Возможные вопросы | Конкуренция по каждому запросу |
| Готовые кластеры «на глаз» | Кластеры по реальной выдаче |
Вывод: модель — генератор гипотез, а не источник данных. Частотность берётся из Вордстата, Search Console или платных сервисов.
Где нейросеть действительно полезна
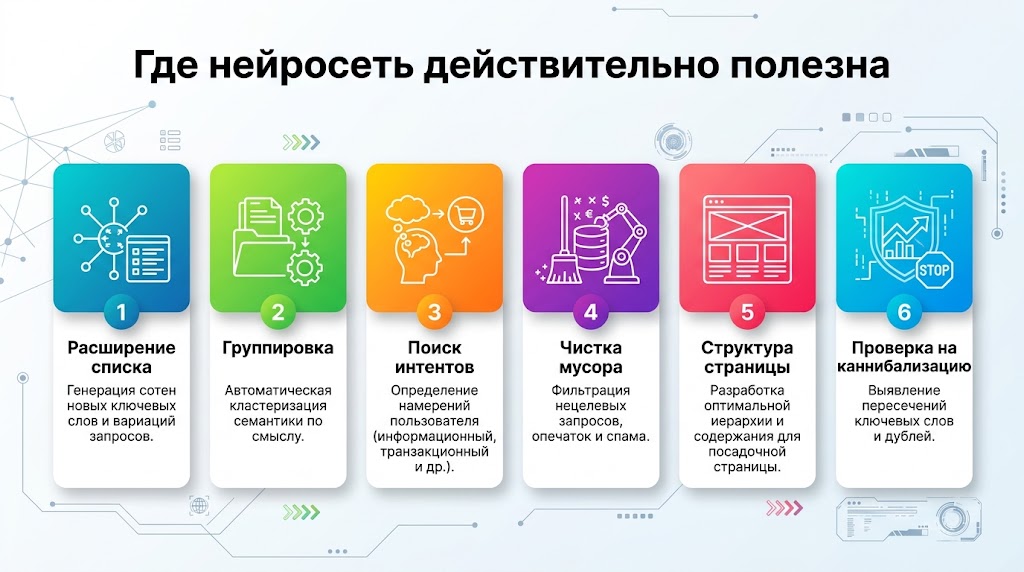
- Расширение списка. Дайте три запроса — получите тридцать формулировок: синонимы, разговорные варианты, вопросы, «как», «почему», «можно ли».
- Группировка. Дайте список из сотни запросов — модель разложит их по смысловым кластерам и назовёт каждый.
- Поиск интентов. «Раздели эти запросы на информационные, коммерческие и навигационные».
- Чистка мусора. «Убери запросы, которые не относятся к теме, и объясни почему».
- Структура страницы. «Под этот кластер предложи структуру статьи: какие H2 закроют какие запросы».
- Проверка на каннибализацию. «Вот два кластера — пересекаются ли они, стоит ли писать две статьи».
Рабочий порядок
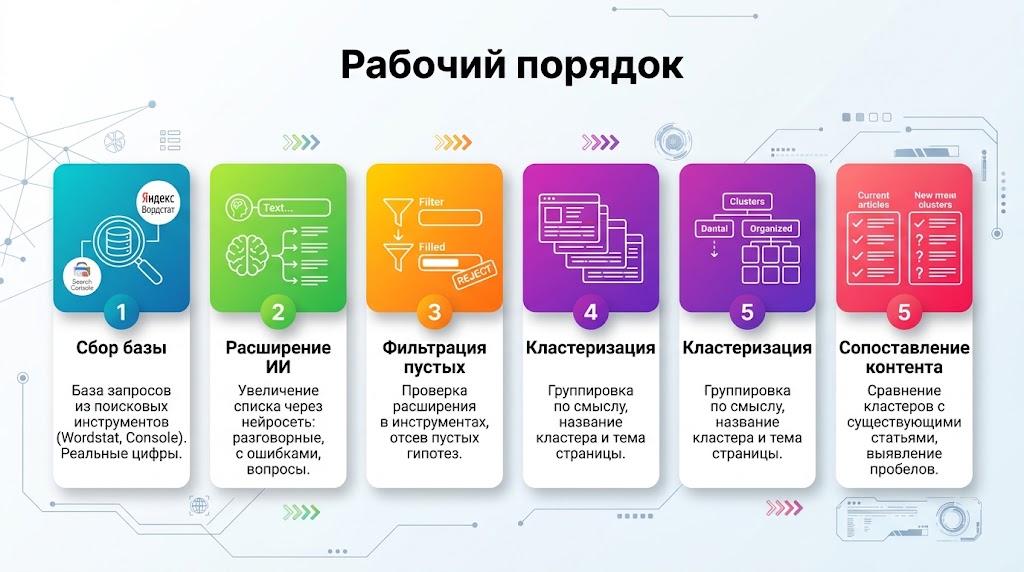
- Соберите базу в поисковых инструментах. Вордстат, Search Console, Wordstat-сервисы — оттуда берутся реальные цифры.
- Расширьте нейросетью. «Вот 10 запросов по теме [тема]. Дай ещё 20 формулировок, которые люди могут вводить: разговорные, с ошибками, в виде вопросов».
- Проверьте расширение в инструментах. Часть гипотез окажется пустой — это нормально, отсеивайте.
- Сгруппируйте. «Разбей этот список на кластеры по смыслу, к каждому дай название и одну строку — о чём страница».
- Сопоставьте с существующими статьями. «Вот наши текущие заголовки — какие кластеры уже закрыты, какие нет».
Типичные ошибки
Верить частотности от модели. Если она пишет «этот запрос очень популярен» — это догадка, а не данные.
Брать всё подряд. Из тридцати сгенерированных фраз реально работают пять-семь. Остальные — либо пустые, либо не про вас.
Игнорировать интент. «Купить» и «что такое» — разные страницы. Модель это различает, если попросить, но сама не предложит.
Забыть про каннибализацию. Две статьи под близкие кластеры конкурируют друг с другом. Спрашивайте модель прямо: «эти темы пересекаются?»
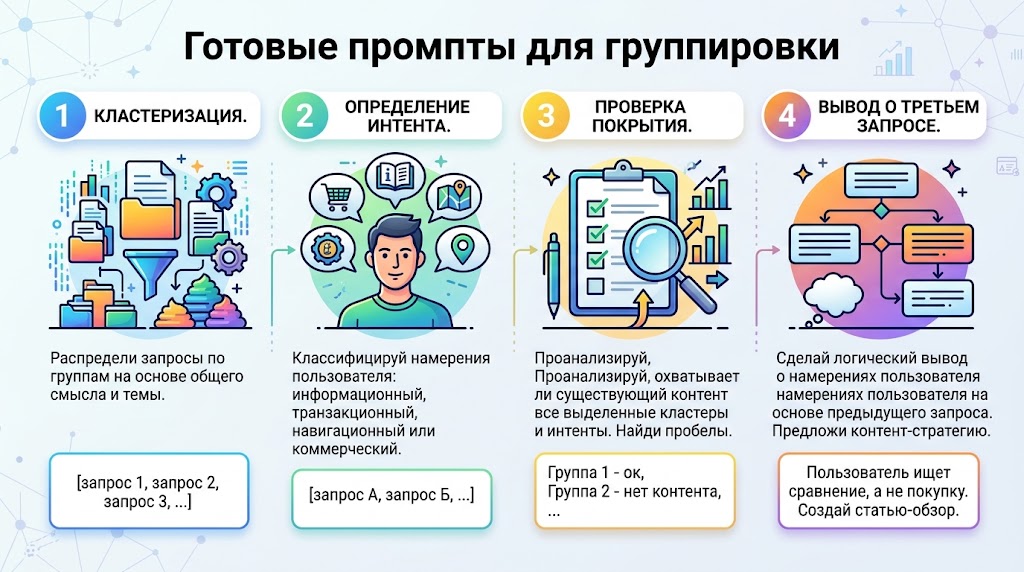
Готовые промпты для группировки
Скопируйте и подставьте свой список — три запроса закрывают основную работу.
Кластеризация:
Вот список запросов: [вставить]. Разбей на смысловые кластеры. Для каждого: название, одна строка — о чём страница, и список запросов внутри. Запросы, которые не относятся к теме, вынеси отдельно с пометкой «мусор».
Определение интента:
Для каждого кластера определи интент: информационный, коммерческий или навигационный. Поясни в одну фразу. Отметь кластеры, где интент неоднозначен.
Проверка покрытия:
Вот наши существующие статьи: [заголовки]. Вот кластеры: [список]. Отметь, какие кластеры уже закрыты, какие закрыты частично, а какие пустые. Для частично закрытых скажи, чего не хватает.
Третий запрос — самый полезный, если сайт уже большой. Он находит не «новые темы», а дыры внутри существующих — и это часто выгоднее, чем писать с нуля.
Одна оговорка
Модель группирует по смыслу, а поиск — по выдаче. Иногда два запроса выглядят близкими, но в выдаче по ним совершенно разные страницы: значит, и статьи нужны разные. Проверяйте спорные кластеры вручную, открыв выдачу по каждому.
Практическое правило: если сомневаетесь, один это кластер или два, — сделайте один хороший текст и посмотрите на позиции через месяц. Две слабые статьи под близкие запросы конкурируют друг с другом и в итоге проигрывают обе.
Частые вопросы
Может ли нейросеть заменить Вордстат?
Нет. Она не знает частотности. Заменить она может разве что этап придумывания формулировок.
Как попросить расширить список запросов?
«Вот 10 запросов по теме. Дай ещё 20: синонимы, разговорные варианты, вопросы, варианты с ошибками». Потом проверьте каждое в инструментах.
Как группировать запросы?
«Разбей на кластеры по смыслу: к каждому название и одна строка о чём страница. Отдельно отметь запросы, которые не относятся к теме».
Что такое каннибализация и как её проверить?
Это когда две страницы конкурируют за один запрос. Проверка: дайте модели два кластера и спросите, можно ли закрыть их одной статьёй.
Можно ли доверять интентам от модели?
В целом да, но проверяйте по выдаче: если по запросу в топе магазины — интент коммерческий, даже если модель назвала его информационным.
Сколько запросов давать за раз?
До сотни — нормально. Больше — модель начнёт путаться и терять позиции в списке, тогда делите на части.
О том, как писать по собранному кластеру, — в статье SEO-текст с нейросетью. О продающих текстах — в статье нейросеть для лендинга.