Исследователи протестировали множество моделей искусственного интеллекта на простом логическом вопросе — и почти все потерпели неудачу.
Сможете ли вы найти ответ?
Как вы считаете, превосходит ли искусственный интеллект человеческий? Это не вопрос из программы по философии, а то, что мы вправе спросить себя, видя прогресс технологии. В некоторых областях он даже пугает: ИИ уже применяется для выявления заболеваний, которые не удаётся обнаружить специалистам.
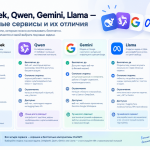
Однако исследование организации LAION показывает, что до господства машин далеко. Протестировали множество языковых моделей: GPT-3.5, GPT-4 vision и GPT-4o от OpenAI, Claude 3 Opus от Anthropic, Gemini от Google, Llama от Meta, Mixtral от Mistral. Протокол был простым: ответить на задачу про «Алису в стране чудес».
В чём подвох задачи
Вопрос звучит так: «У Алисы [X] братьев и [Y] сестёр. Сколько сестёр у брата Алисы?»
Ловушка в том, что ответ не зависит от X и Y. У любого брата Алисы ровно одна сестра — сама Алиса. Остальные девочки в семье приходятся ему сёстрами, но счёт ведётся от Алисы: все братья — её братья, а значит, у каждого из них сестра одна и та же.
Задача проверяет не арифметику, а умение удержать отношение между персонажами. Именно на этом модели и ломаются.
Как ошибаются модели
Llama 3 от Meta на формулировку «У Алисы четыре брата и одна сестра» ответила, что у каждого брата «только одна сестра — сама Алиса». И тут же сама себе противоречила, добавив, что у них по две сестры.
Хуже другое: модель уверена в своём ответе. Как отмечено в исследовании, «модели выражают чрезмерную уверенность в своих ошибочных решениях, предоставляя зачастую абсурдные объяснения, чтобы оправдать и поддержать обоснованность явно ошибочных ответов».
Кто справился
Единственной с отличием вышла GPT-4o: 65 % правильных ответов — в зависимости от формулировки. Остальные модели ошибались заметно чаще.
Особенно удивительно это на фоне других результатов: те же модели показывали хорошие баллы в тестах MMLU — на «многозадачное понимание языка», где проверяют способность решать задачи. Исследователи расхождение не объясняют, но указывают: методики измерения пора пересматривать.
Что это значит на практике
Для пользователя вывод простой: модель может уверенно сказать неправильное — и не признаться в этом. Логические задачи с отношениями между объектами («у каждого брата», «все, кроме», «не более двух») до сих пор остаются слабым местом.
Помогает постановка вопроса: попросите модель объяснить ход решения по шагам и покажите контрпример — «если у Алисы ноль братьев, задача теряет смысл; ответь заново». Часто это вытаскивает правильный результат.
Проверить модели на своих задачах можно бесплатно: на gpt-chatbot.ru доступны GPT-5, DeepSeek и другие — без регистрации, VPN и подписки, с переключением модели прямо в диалоге.
Частые вопросы
Какой правильный ответ на задачу?
Одна сестра. Счёт ведётся от Алисы: у каждого её брата есть только сама Алиса в качестве сестры, сколько бы сестёр ни было в семье.
Почему модели ошибаются на такой простой задаче?
Они ориентируются на статистику текста, а не на модель отношений между людьми. Формулировка с числами сбивает: модель пытается их перемножать и складывать.
Улучшились ли модели с тех пор?
Да, модели-рассуждения решают подобные задачи устойчивее: они разбирают условие по шагам. Но полагаться на безупречную логику всё ещё нельзя.
Как проверить ответ нейросети?
Попросите объяснить ход решения и предложить контрпример. Если объяснение «плывёт» — ответу доверять нельзя.