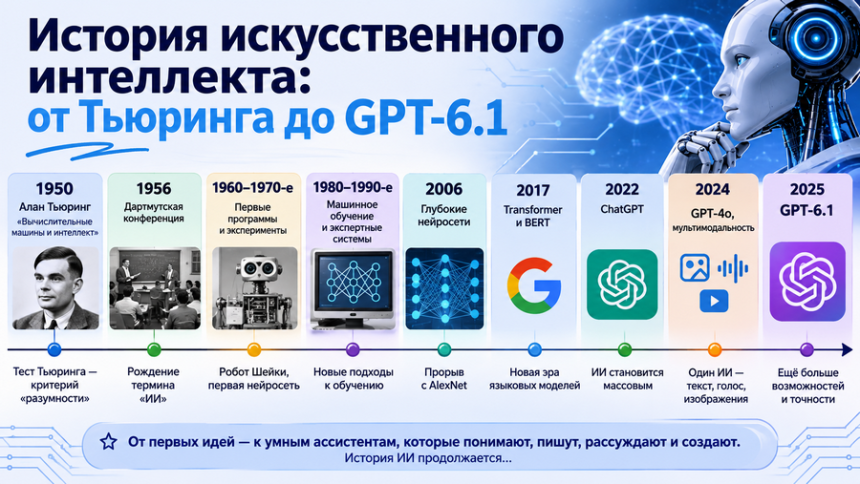
Искусственный интеллект — область информатики, занимающаяся созданием систем, способных выполнять задачи, которые традиционно требуют человеческого интеллекта: понимание языка, распознавание образов, планирование, обучение и принятие решений.
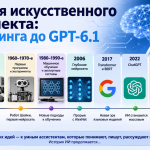
Его история насчитывает не десять лет, как может показаться по новостям, а более семидесяти — от математических работ середины XX века до современных больших языковых моделей. За это время область пережила два периода спада, несколько смен парадигмы и, наконец, взрывной рост, превративший её из академической дисциплины в технологию, которой ежедневно пользуются сотни миллионов людей.
Эта статья описывает развитие искусственного интеллекта по этапам: философские и математические предпосылки, рождение термина, эпоху символьных систем, «зимы» и возрождение, революцию глубокого обучения, появление трансформеров и современных генеративных моделей — текстовых, графических, видео- и аудиомоделей.
Предпосылки: от мифа к математике
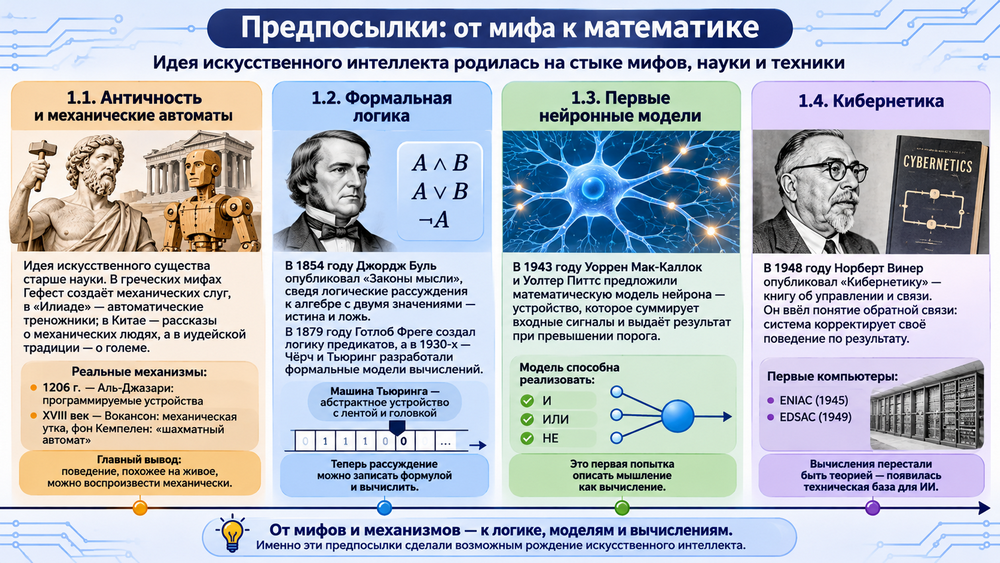
1.1. Античность и механические автоматы
Идея искусственного существа старше науки. В греческих мифах Гефест создаёт механических слуг, в «Илиаде» описаны автоматические треножники; в китайской традиции есть рассказы о механических людях, а в еврейской — о големе, оживлённом словом. Это не техника, но это важная культурная рамка: мысль о том, что разум можно воспроизвести, возникла задолго до возможности её проверить.
Реальные механизмы появились в эпоху Возрождения. В 1206 году Аль-Джазари описал автоматические устройства с программируемыми действиями; в XVIII веке Вокансон построил механическую утку, а фон Кемпелен — «шахматный автомат» (как выяснилось позже, с человеком внутри). Эти устройства не были разумными, но они показали главное: поведение, похожее на живое, можно воспроизвести механически.
1.2. Формальная логика
Второй предпосылкой стала математическая логика. В 1854 году Джордж Буль опубликовал «Законы мысли», сведя логические рассуждения к алгебре с двумя значениями — истина и ложь. Это был решающий шаг: если рассуждение можно записать формулой, то его можно и вычислить.
В 1879 году Готлоб Фреге создал логику предикатов, а в 1930-х годах Алонзо Чёрч и Алан Тьюринг независимо разработали формальные модели вычислений. Машина Тьюринга — абстрактное устройство с лентой и головкой — показала, что любой алгоритм можно реализовать механически. Именно на этой идее построены все современные компьютеры и, в конечном счёте, все нейросети.
1.3. Первые нейронные модели
В 1943 году Уоррен Мак-Каллок и Уолтер Питтс опубликовали работу «Логическое исчисление идей, относящихся к нервной деятельности». Они предложили математическую модель нейрона — устройство, которое суммирует входные сигналы и выдаёт результат при превышении порога. Формально такая модель способна реализовать логические операции И, ИЛИ, НЕ.1
Это была первая попытка описать мышление как вычисление на сети простых элементов. Сегодняшние нейросети с миллиардами параметров — прямые потомки этой модели, хотя между ними и лежит восемьдесят лет развития.
1.4. Кибернетика
В 1948 году Норберт Винер опубликовал «Кибернетику» — книгу об управлении и связи в живых организмах и машинах. Он ввёл понятие обратной связи: система корректирует своё поведение по результату. Это понятие стало основой и обучающихся алгоритмов, и современных агентных систем, которые проверяют результат своих действий.2
Тогда же, в конце 1940-х, появились первые вычислительные машины: ENIAC (1945), EDSAC (1949). Вычисления перестали быть теоретической возможностью — появилась техническая база для проверки идей.
Рождение дисциплины (1950–1956)
2.1. Тест Тьюринга

В 1950 году Алан Тьюринг опубликовал в журнале Mind статью «Вычислительные машины и разум». Вместо философского спора о том, «может ли машина думать», он предложил операциональный критерий: если в текстовом диалоге человек не может отличить машину от человека, поведение машины следует считать разумным.3
Этот критерий — «имитационная игра», позже названная тестом Тьюринга, — вызвал споры, которые не утихли до сих пор. Важно другое: статья задала рамку, в которой область развивалась десятилетиями. Современные чат-боты проходят ранние версии теста без подготовки, но это не значит, что они «думают» — сама постановка вопроса оказалась сложнее, чем казалось в 1950 году.
2.2. Семинар в Дартмуте
Летом 1956 года в Дартмутском колледже прошёл исследовательский семинар, организованный Джоном Маккарти, Марвином Мински, Натаниэлем Рочестером и Клодом Шенноном. В заявке на грант Маккарти использовал термин artificial intelligence — «искусственный интеллект». Считается, что именно с этого документа термин вошёл в научный оборот.4
Заявка содержала смелое утверждение: «каждый аспект обучения или любую другую особенность интеллекта можно описать настолько точно, что машину можно будет заставить его имитировать». Семинар длился несколько недель, в нём участвовали около десяти человек — но именно он считается точкой отсчёта дисциплины.

2.3. Логик-теоретик и первые программы
Ещё до семинара, в 1955–1956 годах, Аллен Ньюэлл, Герберт Саймон и Клифф Шоу написали «Логик-теоретик» — программу, доказывающую теоремы из «Начал» Уайтхеда и Рассела. Программа нашла доказательство для 38 теорем, а для одной — более короткое, чем в книге.
В 1958 году появился язык LISP, созданный Джоном Маккарти. Он стал основным языком символьного ИИ на тридцать лет и до сих пор используется в исследованиях. Его ключевая идея — представление программ и данных в одной форме — оказала влияние далеко за пределами ИИ.
Золотой век символьного ИИ (1956–1974)
3.1. Перцептрон Розенблатта
В 1958 году Фрэнк Розенблатт представил перцептрон — обучаемую модель, которая классифицировала изображения по набору весов. В отличие от символьных систем, перцептрон не следовал правилам: он настраивал параметры на примерах. Это была первая работающая реализация идеи «обучение вместо программирования».5
Розенблатт построил физическое устройство — Mark I Perceptron, — которое распознавало простые изображения. Пресса писала о машине, которая «учится думать». Именно тогда возникло разделение, определившее развитие области на десятилетия: символьный подход (логика и правила) против коннекционистского (нейронные сети и обучение).
3.2. Критика Минского и первый спад
В 1969 году Марвин Мински и Сеймур Паперт опубликовали книгу «Перцептроны». В ней математически показано, что однослойный перцептрон не может решить задачу «исключающего ИЛИ» — а значит, не способен распознавать ряд простых закономерностей. Книга также поставила под сомнение целесообразность многослойных сетей, указав на отсутствие метода их обучения.7
Эффект был разрушительным. Финансирование нейросетевых исследований резко сократилось почти на десятилетие. Символьный подход остался единственным магистральным направлением — а проблема обучения многослойных сетей оставалась нерешённой до 1986 года.
3.3. ELIZA и первый чат-бот
В 1966 году Джозеф Вейценбаум из MIT написал ELIZA — программу, имитирующую психотерапевта. Она не понимала смысла: скрипт искал ключевые слова и переформулировал фразы в вопросы. На реплику «Мне плохо» она отвечала «Почему вам плохо?».6
Реакция оказалась неожиданной: люди рассказывали ELIZA личные вещи и приписывали ей понимание, которого не было. Вейценбаум был этим обеспокоен и позже писал, что программа демонстрирует не разум машины, а склонность человека к антропоморфизму. Этот эффект — «эффект ELIZA» — фиксируется и сегодня, уже у больших языковых моделей.

3.4. SHRDLU и «блоки мира»
В конце 1960-х Терри Виноград создал SHRDLU — программу, понимавшую команды о мире из геометрических фигур: «поставь куб на большой красный блок». Программа отвечала на вопросы, уточняла и объясняла свои действия.
SHRDLU впечатлял современников: казалось, что понимание языка почти решено. Но работало это только в узком «мире блоков». Как только речь выходила за его пределы, система терялась — и это стало наглядным уроком о разнице между пониманием в ограниченной модели и пониманием в реальности.
3.5. Программы-решатели и первые оптимизмы
В эти же годы появились GPS (General Problem Solver) Ньюэлла и Саймона — универсальный решатель задач через поиск в пространстве состояний, и STROBE, и STUDENT — программы, решавшие алгебраические текстовые задачи.
Оптимизм был высок. В 1970 году Марвин Мински сказал, что «в пределах одного поколения проблема создания искусственного интеллекта будет существенно решена». В 1958 году Герберт Саймон и Аллен Ньюэлл предсказывали, что через десять лет компьютер станет чемпионом мира по шахматам (это случилось в 1997-м) и докажет важную математическую теорему (это случилось в 1976-м, с теоремой о четырёх красках — и с оговорками).
Эти предсказания не сбылись в срок и стали частью более широкой проблемы: завышенные ожидания порождают разочарование, а разочарование — сокращение финансирования.
Первая «зима» (1974–1980)
4.1. Доклад Лайтхилла
В 1973 году британский математик сэр Джеймс Лайтхилл подготовил для правительства Великобритании доклад о состоянии исследований ИИ. Вывод был жёстким: существующие системы не масштабируются, а обещания не выполняются. Доклад рекомендовал сократить финансирование, и рекомендация была принята.8
Параллельно в США агентство DARPA, финансировавшее значительную часть работ, потребовало перейти от «общих» исследований к прикладным задачам. Университеты потеряли основную поддержку.
4.2. Фундаментальные ограничения
Причины спада были техническими, а не политическими. Три проблемы, которые символьный ИИ не мог решить:
- Комбинаторный взрыв. Поиск решения перебором рос экспоненциально с размером задачи.
- Проблема commonsense knowledge. Чтобы понимать язык, нужно знать огромное количество «очевидных» вещей о мире — а записать их правилами оказалось невозможно.
- Отсутствие обучения. Системы не улучшались от опыта: каждое новое знание нужно было программировать вручную.
Именно третья проблема стала ключевой. Стало ясно, что путь «запрограммировать всё» упирается в человеческие ресурсы, а не в железо.
4.3. Что выжило
Несмотря на спад, в эти годы появились важные работы. В 1974 году Пол Вербос и Дэвид Румельхарт опубликовали описание метода обратного распространения ошибки — того самого, который через двенадцать лет станет основой обучения нейросетей. Работа осталась почти незамеченной.
В 1972 году появился язык Prolog, созданный Аленом Кольмероэ, — декларативный язык логического программирования, ставший основой европейской школы ИИ. А в 1973 году вышла «Программа Строки» — нет, это неточно: в этот период были заложены основы экспертных систем в Стэнфорде, которые вывели область из кризиса.
Экспертные системы и вторая волна (1980–1987)
5.1. Как ИИ вернулся в промышленность
Выход из первой зимы был найден не в фундаментальной науке, а в узкой специализации. Вместо «универсального интеллекта» — системы, которые имитируют решения конкретного специалиста в узкой предметной области.
Первой коммерчески успешной экспертной системой стала XCON (1980), разработанная в Digital Equipment Corporation. Она собирала конфигурации компьютеров по заказу: тысячи правил, описывающих совместимость комплектующих. Система, по оценкам компании, экономила десятки миллионов долларов в год.
Вслед за ней появились MYCIN (диагностика инфекций крови), CADUCEUS (внутренняя медицина), DENDRAL (химический анализ) и сотни коммерческих систем. В середине 1980-х рынок экспертных систем оценивался в миллиарды долларов, а Япония запустила национальную программу «пятого поколения» с бюджетом в полмиллиарда.
5.2. Как они работали
Экспертная система состояла из двух частей: база знаний (правила вида «если А, то Б») и машина вывода, которая применяла правила к фактам. Знания извлекали из экспертов в ходе интервью — этот процесс называли «извлечением знаний» и он оказался самым узким местом технологии.
Типичная проблема: чтобы система работала, нужно было сформулировать тысячи правил, а каждая новая ситуация требовала новых. Система не обучалась и не переносила знания.
5.3. Обратное распространение ошибки
Параллельно, вне мира экспертных систем, произошёл прорыв, значение которого тогда не осознали. В 1986 году Дэвид Румельхарт, Джеффри Хинтон и Рональд Уильямс опубликовали в журнале Nature статью об обучении представлений методом обратного распространения ошибки.9
Метод решал ту самую проблему, которую Мински и Паперт обозначили в 1969 году: как обучать многослойную сеть. Ошибка вычисляется на выходе, затем распространяется обратно по слоям, и каждый вес корректируется на свою долю. Это сделало возможным обучение сетей с несколькими слоями — то, что позже назовут «глубоким обучением».

5.4. Свёрточные сети
В 1989 году Ян Лекун в Bell Labs представил свёрточную нейронную сеть (CNN), обученную распознавать рукописные цифры в базе MNIST. Архитектура опиралась на идею, что нейрон должен реагировать на локальный фрагмент изображения, а не на всё целиком — как устроено зрение у животных.10
К 1998 году система LeNet-5 распознавала цифры на чеках с точностью, достаточной для банковского применения. Это был первый случай, когда нейросеть приносила реальную коммерческую пользу в масштабе — и первое свидетельство, что коннекционистский подход способен на то, чего не могут правила.
5.5. Вторая зима
К 1987 году пузырь экспертных систем лопнул. Причины были те же, что и в первый раз: завышенные обещания, высокая стоимость поддержки баз знаний и, главное, хрупкость — система, работающая в лаборатории, ломалась при малейшем отклонении от описанных ситуаций.
Японская программа «пятого поколения» не дала ожидаемых результатов, рынок LISP-машин рухнул, а DARPA вновь сократила финансирование. Область вошла во вторую «зиму» — менее публичную, но не менее тяжёлую: многие исследователи ушли в смежные области, а слово «искусственный интеллект» в заявках на гранты старались не использовать.
Эпоха машинного обучения (1990–2012)
6.1. Смена парадигмы
Выход из второй зимы произошёл через отказ от идеи «запрограммировать знание». Вместо этого системы стали учиться на данных — и это изменило всё.
Ключевое различие: символьный ИИ требовал, чтобы человек сформулировал правила; машинное обучение требует, чтобы человек предоставил примеры. Первое ограничено знаниями программиста, второе — количеством и качеством данных.
6.2. Статистические методы
В 1990-е годы доминировали статистические подходы: машины опорных векторов (SVM), метод опорных векторов, байесовские сети, скрытые марковские модели. Они давали измеримые результаты и хорошо работали на практических задачах — от фильтрации спама до распознавания речи.
Именно тогда появилась фраза, приписываемая Фреду Джаннику из IBM: «Каждый раз, когда я увольняю лингвиста, качество распознавания речи улучшается». Она отражала смену приоритетов: не правила языка, а статистика на больших корпусах.
6.3. Победа над человеком в шахматах
В мае 1997 года компьютер Deep Blue компании IBM победил действующего чемпиона мира Гарри Каспарова в матче из шести партий со счётом 3,5 : 2,5. Это была не нейросеть: Deep Blue работал на переборе с оценочной функцией, настроенной гроссмейстерами, и просчитывал до 200 миллионов позиций в секунду.
Победа стала символической вехой, но показала и границу подхода: в шахматах есть чёткие правила и измеримый результат, поэтому перебор работает. В задачах без формальных правил — понимание текста, распознавание образов — этот путь не работал.

6.4. Большие данные
К концу 2000-х сложились три условия, которых не было раньше: вычислительные мощности (GPU), объёмы данных (интернет) и алгоритмы (глубокие сети). Их соединение и дало взрыв 2012 года.
В 2009 году группа Джеффри Хинтона и студенты из Торонто выиграли конкурс по распознаванию рукописных цифр, а в 2011 году — конкурс по распознаванию речи, снизив ошибку почти вдвое относительно предыдущих систем. Это были первые сигналы, что глубокие сети обходят классические методы.
Революция глубокого обучения (2012–2017)
7.1. AlexNet и точка перелома
В сентябре 2012 года Алекс Крижевский, Илья Суцкевер и Джеффри Хинтон представили нейросеть AlexNet на конкурсе ImageNet по распознаванию изображений. Она показала ошибку 15,3% против 26,2% у следующего участника — разрыв, который в этой области считался невозможным.11
Ключевыми оказались три вещи: свёрточная архитектура, обучение на двух игровых видеокартах NVIDIA и большой набор данных. Именно с этого момента GPU стали стандартом для обучения нейросетей, а глубокое обучение — магистральным направлением.
Через год все участники ImageNet использовали нейросети. Через пять лет ошибка упала ниже 3% — уровня, на котором ошибаются люди.
7.2. Почему это сработало именно тогда
Идеи глубоких сетей существовали с 1980-х. Изменились три компонента:
- Данные. ImageNet (2009) содержал 14 миллионов размеченных изображений — в тысячи раз больше, чем наборы 1990-х.
- Вычисления. Графические процессоры, созданные для игр, оказались идеальны для матричных операций.
- Алгоритмы. Функции активации ReLU, dropout, пакетная нормализация — набор приёмов, сделавших обучение глубоких сетей устойчивым.
7.3. AlphaGo
В марте 2016 года система AlphaGo компании DeepMind победила Ли Седоля, одного из сильнейших игроков в го, со счётом 4:1. Го считалось неприступным для компьютеров: число возможных позиций превышает число атомов в наблюдаемой Вселенной, поэтому перебор невозможен.
AlphaGo сочетала две нейросети (оценочную и «политики») с методом Монте-Карло и обучением на миллионах партий. Вторая партия матча, где система сделала ход, который комментаторы сочли ошибкой, а он оказался гениальным, стала символом: машина нашла решение, недоступное человеческой интуиции.
В 2017 году AlphaGo Zero обучилась с нуля, играя сама с собой, и превзошла предыдущую версию за три дня — без единой человеческой партии в обучающих данных.

7.4. Распознавание речи и синтез
В эти же годы нейросети вытеснили классические методы в обработке звука. К 2015 году системы распознавания речи на глубоких сетях снизили ошибку до уровня ниже человеческой на коротких фразах. Появились первые голосовые помощники нового поколения — Siri (2011), Google Assistant (2016), Alexa (2014).
Синтез речи тоже изменился: вместо конкатенации записанных фрагментов появились модели WaveNet (2016), генерирующие звук по сэмплам. Голос стал почти неотличим от человеческого — и это позже стало основой для синтеза речи в реальном времени.
Трансформеры и большие языковые модели (2017–2022)
8.1. «Attention Is All You Need»
В июне 2017 года восемь исследователей Google опубликовали статью «Attention Is All You Need», в которой предложили архитектуру трансформера. Отказ от рекуррентности в пользу механизма внимания — когда модель взвешивает значимость каждого слова относительно каждого другого — решил две проблемы: скорость обучения и удержание дальних связей в тексте.12
Это самая влиятельная статья в истории современного ИИ. Все большие языковые модели — GPT, Claude, Gemini, LLaMA, DeepSeek, Qwen — построены на трансформерах. Архитектура оказалась универсальной: её применили и к изображениям (ViT), и к звуку, и к видео.

8.2. GPT: от первой версии к третьей
В 2018 году OpenAI представила GPT-1 — модель на 117 миллионов параметров, обученную на книгах. Идея была простой и радикальной: не учить модель конкретным задачам, а обучить её предсказывать следующее слово на огромном корпусе текста. Оказалось, что из этого навыка вырастают и перевод, и ответы на вопросы, и написание кода.
В 2019 году вышла GPT-2 (1,5 миллиарда параметров). OpenAI сначала отказалась публиковать её полностью, ссылаясь на риск злоупотреблений, — это решение вызвало споры и стало первым случаем, когда компания ограничила доступ к модели из соображений безопасности.
В 2020 году GPT-3 (175 миллиардов параметров) показала главное: при достаточном масштабе модель выполняет новые задачи по одному примеру в запросе, без дообучения. Это явление назвали «обучением в контексте», и оно стало основой всей современной практики работы с чатами.14
8.3. BERT и двунаправленность
Почти одновременно Google представила BERT (2018) — модель, которая смотрит на текст в обе стороны и предсказывает пропущенные слова. BERT стал стандартом для поиска и классификации, тогда как GPT — для генерации. Это разделение сохраняется: одни модели лучше понимают, другие — создают.
8.4. Генерация изображений
В январе 2021 года OpenAI показала DALL-E — модель, генерирующую изображения по текстовому описанию. В том же году вышла CLIP, связавшая текст и изображения в общем пространстве: она научилась понимать, насколько картинка соответствует описанию.16, 17
В 2022 году Stable Diffusion сделала генерацию изображений массовой: модель с открытыми весами, запускаемая на обычной видеокарте. За ней последовала Midjourney — сервис с акцентом на художественное качество. За год генерация изображений прошла путь от лабораторной демонстрации до инструмента, которым пользуются дизайнеры.
8.5. Код и Copilot
В 2021 году GitHub выпустил Copilot — автодополнение кода на основе модели OpenAI. Он стал первым массовым продуктом, где ИИ встроен непосредственно в рабочий инструмент разработчика. К 2023 году им пользовались миллионы программистов, а исследования показывали ускорение выполнения типовых задач на 30–50%.
ChatGPT и массовое распространение (2022–2023)
9.1. 30 ноября 2022 года
30 ноября 2022 года OpenAI открыла публичный доступ к ChatGPT — интерфейсу к модели GPT-3.5, дообученной на диалогах. Это была не новая модель в смысле возможностей, а новый способ взаимодействия: не «промпт-инженер», а обычный человек задаёт вопрос своими словами и получает связный ответ.
За пять дней сервис набрал миллион пользователей, за два месяца — сто миллионов. Это стало самым быстрым ростом пользовательской базы в истории потребительских продуктов на тот момент.
Причина была не только в качестве модели. Совпали три вещи: достаточно хорошее качество для повседневных задач, бесплатный доступ через веб-интерфейс и эффект «это нужно попробовать». Миллионы людей впервые увидели, что ИИ — не футурология, а инструмент здесь и сейчас.

9.2. Реакция индустрии
Microsoft инвестировала в OpenAI и встроила модели в Bing и Office; Google объявила «красный код» и ускорила разработку Gemini; Meta открыла LLaMA. Китайские компании — Baidu, Alibaba, DeepSeek — выпустили собственные модели. За полгода рынок изменился полностью.
Важным событием стала утечка весов LLaMA (2023), после которой открытые модели начали догонять закрытые. Появилось целое сообщество, дообучающее модели на своих данных — от медицины до программирования.
9.3. GPT-4
В марте 2023 года вышла GPT-4. Ключевые изменения: мультимодальность (понимание изображений), более длинный контекст, заметно лучшее качество в сложных задачах — особенно в юриспруденции, медицине и программировании. Модель прошла ряд профессиональных экзаменов на уровне, сопоставимом с человеческим.19
OpenAI не раскрыла архитектуру и размер GPT-4, сославшись на конкуренцию и безопасность. Это стало прецедентом: ведущие модели перестали быть открытыми, и область разделилась на «закрытый фронтир» и «открытые модели».
9.4. Конкуренты
Anthropic выпустила Claude — модель с акцентом на безопасность и длинный контекст (до 200 тысяч токенов), популярную в работе с документами. Google представила Gemini как мультимодальную модель «изначально», а не с добавленной модальностью. Meta продолжила линию LLaMA, выпустив Llama 2 и Llama 3 с открытыми весами.
DeepSeek — китайская компания, показавшая, что качественные модели можно обучать значительно дешевле, чем считалось. Её модели с открытыми весами соревновались с проприетарными в математике и коде, а публикация технических деталей вызвала пересмотр оценок стоимости обучения.20
9.5. Регулирование
В 2023 году ЕС принял AI Act — первый комплексный закон об искусственном интеллекте, классифицирующий системы по уровню риска. США выпустили исполнительный указ о безопасности ИИ, Китай — правила для генеративных сервисов, требующие маркировки сгенерированного контента.
Регулирование стало частью технологии: крупные модели теперь проектируются с учётом требований к прозрачности, а компании публикуют «карты моделей» с описанием обучающих данных и ограничений.
Мультимодальность: картинки, видео, звук (2023–2026)
10.1. Изображения
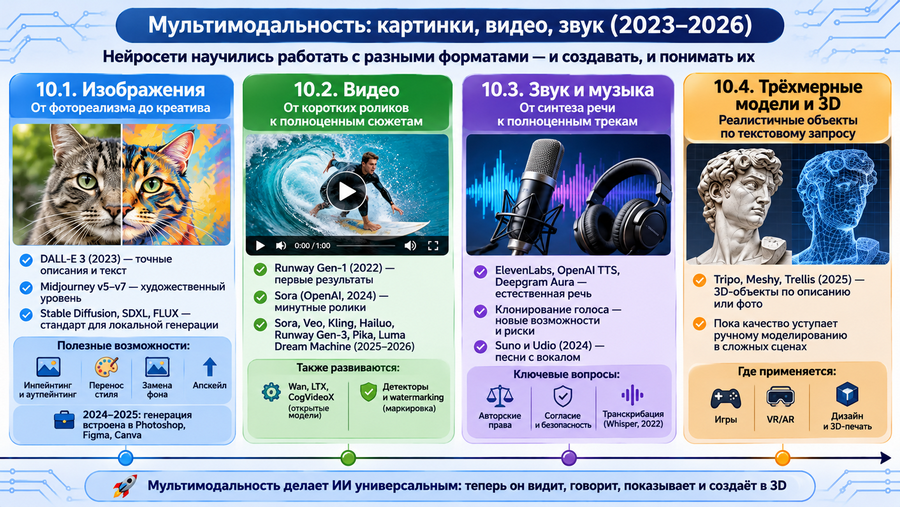
К 2023 году генерация изображений достигла качества, при котором результат неотличим от фотографии в типовых сценах. DALL-E 3 (2023) научилась точно следовать сложным описаниям и рисовать текст; Midjourney v5–v7 дала художественный уровень, сравнимый с иллюстрацией; Stable Diffusion и её производные (SDXL, FLUX) стали стандартом для локальной генерации.
Появились специализированные задачи: инпейнтинг (дорисовка фрагмента), аутпейнтинг (расширение кадра), перенос стиля, замена фона, апскейл. В 2024–2025 годах генерация встроилась в рабочие инструменты — Photoshop, Figma, Canva.
10.2. Видео
Генерация видео оказалась значительно сложнее: нужно сохранять согласованность объектов во времени. Первые результаты (Runway Gen-1, 2022) давали короткие размытые фрагменты. Прорыв произошёл в 2024 году, когда OpenAI показала Sora — модель, генерирующую минутные ролики с сохранением физики и персонажей.
К 2025–2026 годам рынок сформировался: Sora (OpenAI), Veo (Google), Kling и Hailuo (Китай), Runway Gen-3, Pika, Luma Dream Machine. Параллельно развились открытые модели — Wan, LTX, CogVideoX, — которые можно запускать локально, и сервисы на их основе.
Появился и обратный инструмент: детекторы сгенерированного видео и watermarking (маркировка), поскольку вопрос подлинности стал практическим.
10.3. Звук и музыка
Синтез речи перешёл из «роботизированного» в «неотличимый»: ElevenLabs, OpenAI TTS, Deepgram Aura. Появились модели клонирования голоса — и вместе с ними проблемы согласия и мошенничества.
Генерация музыки прошла путь от коротких фрагментов (MuseNet, 2019) до полноценных треков: Suno и Udio (2024) создают песни с вокалом по текстовому описанию. Основным вопросом стали авторские права: модели обучались на существующих записях, и это породило иски от звукозаписывающих компаний.
Отдельное направление — транскрибация: Whisper (2022) сделал расшифровку аудио доступной и точной, и это изменило рабочие процессы в журналистике, медицине и делопроизводстве.
10.4. Трёхмерные модели и 3D
Генерация 3D-объектов развивалась медленнее: задача требует согласованности со всех ракурсов. К 2025 году появились рабочие решения (Tripo, Meshy, Trellis), генерирующие меши по описанию или фотографии, но качество пока уступает ручному моделированию в сложных сценах.
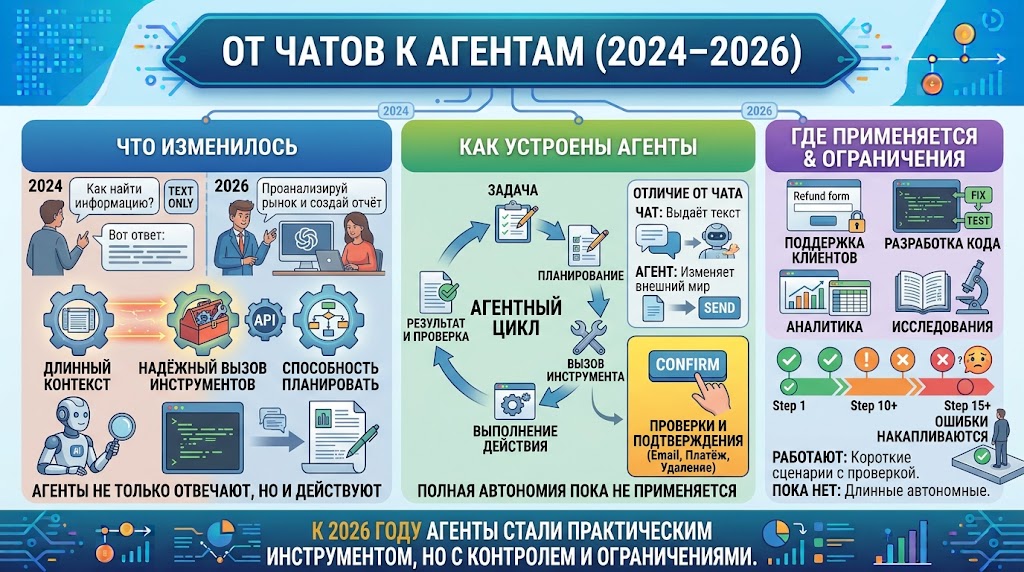
От чатов к агентам (2024–2026)
11.1. Что изменилось
К 2024 году стало ясно, что «умный ответ» — не предел. Следующий шаг — системы, которые не только отвечают, но и действуют: ищут информацию, вызывают сервисы, запускают код, проверяют результат и корректируют план.
Технически это стало возможным благодаря трём вещам: длинному контексту, надёжному вызову инструментов (function calling) и способности моделей планировать последовательность шагов.
11.2. Как устроены агенты
Агент — это цикл: модель получает задачу, решает, какой инструмент использовать, выполняет действие, смотрит на результат и решает, что делать дальше. Отличие от чата принципиальное: чат выдаёт текст, агент изменяет состояние внешнего мира.
Именно поэтому у агентов появились ограничения и подтверждения: перед удалением файла, отправкой письма или платежом система спрашивает человека. Полная автономия в ответственных задачах пока не применяется.
11.3. Где применяется
Агенты уже используются в поддержке клиентов (ответ и оформление возврата), в разработке (написание кода, запуск тестов, исправление ошибок), в аналитике (сбор данных, построение отчётов), в исследованиях (поиск источников и проверка фактов).
Главное ограничение — накопление ошибок в длинных цепочках: после 10–15 шагов вероятность уйти не туда растёт. Поэтому практика такова: короткие агентные сценарии с проверкой на каждом этапе работают, длинные автономные — пока нет.
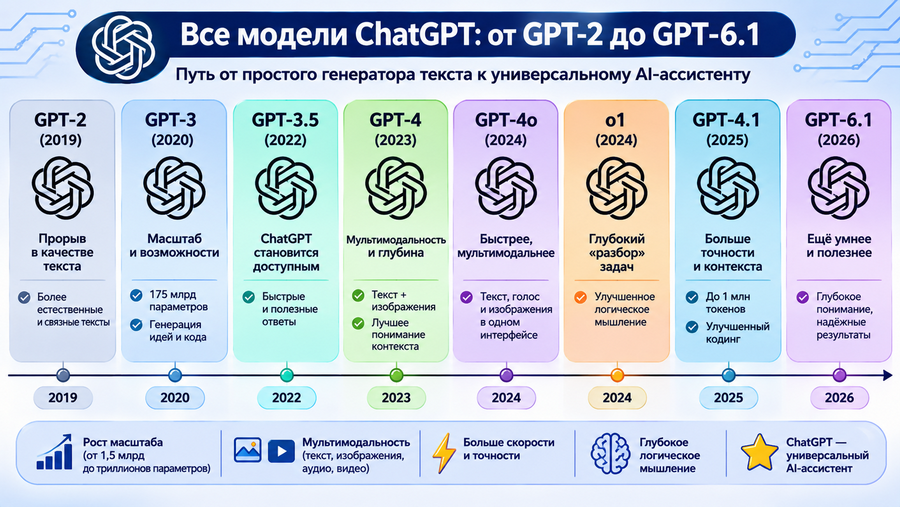
Все модели ChatGPT: от GPT-2 до GPT-6.1
Ниже — история каждой модели линейки GPT по порядку: когда вышла, что изменилось, чем запомнилась. Именно эта последовательность объясняет, почему сегодняшние модели выглядят так, а не иначе: почти каждое поколение решало проблему, обнаруженную в предыдущем.
GPT-2 (февраль 2019)
Первая модель, показавшая, что «просто предсказывать следующее слово» — работающая стратегия. 1,5 миллиарда параметров, обучение на 40 ГБ текстов из Reddit-ссылок (WebText), контекст 1024 токена.
Главное открытие: модель выполняет задачи, которым её не учили, — перевод, суммаризацию, ответы на вопросы — если задать их как продолжение текста. Это назвали zero-shot. OpenAI сначала отказалась публиковать веса целиком, ссылаясь на риск генерации недостоверного контента, и выпускала модель стадиями. Это был первый в истории случай, когда доступ к модели ограничили из соображений безопасности, — и решение до сих пор обсуждается.
GPT-3 (июнь 2020)
175 миллиардов параметров — в сто раз больше GPT-2. Обучение на 300 миллиардах токенов, 96 слоёв, контекст 2048 токенов. Ключевое: модель научилась учиться по нескольким примерам прямо в запросе (few-shot), без дообучения.
Именно GPT-3 сделала языковые модели коммерческим продуктом: появился API с тарификацией по токенам и семейство моделей — davinci, curie, babbage, ada. Стало понятно, что масштаб даёт качество, а качество можно продавать как сервис. Ограничения тоже выяснились здесь: модель не помнила контекст между запросами, плохо следовала инструкциям и уверенно выдумывала факты.
GPT-3.5 и ChatGPT (2022)
Промежуточное поколение, которое изменило всё. Сначала появились модели text-davinci-002 и text-davinci-003, обученные методом RLHF — с подкреплением на отзывах людей. Это решило проблему «модель отвечает, но не так, как просят»: ответы стали следовать инструкции и держать диалог.18
30 ноября 2022 года на этой базе открыли ChatGPT — интерфейс, где не нужно быть инженером. Модель GPT-3.5-turbo получила контекст 4096 токенов и цену $0,002 за тысячу токенов — в десять раз дешевле предшественников. Миллион пользователей за пять дней, сто миллионов за два месяца.
GPT-4 (март 2023)
Первая мультимодальная модель линейки: на вход можно было подавать не только текст, но и изображения. Контекст 8192 токена, в расширенной версии — 32768. Модель прошла экзамены на уровне, сопоставимом с человеческим: юридический экзамен в верхних 10% сдающих, SAT, биология, история.
OpenAI не раскрыла архитектуру и размер — только заявила, что это большая мультимодальная модель. С этого момента фронтир перестал быть открытым, и область разделилась на закрытые и открытые модели.
GPT-4 Turbo (ноябрь 2023)
Инженерное обновление, важное по трём причинам. Контекст вырос до 128 тысяч токенов — стало возможно загружать книги и крупные документы. Знания обновили до апреля 2023 года. Цена упала примерно втрое относительно GPT-4.
Появились и новые режимы: JSON-вывод для интеграций, работа с DALL·E 3 внутри одного диалога, распознавание изображений с более высокой детализацией. Именно GPT-4 Turbo сделала модели пригодными для промышленного применения, а не только для демонстраций.
GPT-4o (май 2024)
«Omni» — единая модель, работающая с текстом, изображением и звуком в одной архитектуре, без промежуточных преобразований. Это дало то, чего не было раньше: голосовой диалог в реальном времени, с паузами, перебиванием и интонацией — как в разговоре с человеком.
Модель работала вдвое быстрее GPT-4 Turbo и стоила вдвое дешевле при сопоставимом качестве. Бесплатная версия получила доступ к GPT-4o с ограничениями — это был момент, когда фронтирные модели перестали быть платными по определению.
o1 (сентябрь 2024)
Отдельная линейка «рассуждающих» моделей. Вместо немедленного ответа o1 строит длинную цепочку рассуждений и проверяет себя — это дало качественный скачок в математике, программировании и научных задачах. На олимпиадных задачах по математике модель вошла в число сильнейших участников.
Цена — время и токены: на сложный вопрос модель может «думать» минуты. Зато там, где нужна точность, а не скорость, подход оказался принципиально лучше.
GPT-4.5 (февраль 2025)
Промежуточная модель, ориентированная не на бенчмарки, а на качество общения: более естественный язык, лучшее понимание контекста и эмоциональных нюансов, меньше «роботизированности». Считалась самой большой из выпущенных на тот момент, но и самой дорогой — из-за чего не стала массовой.
GPT-5 (август 2025)
Первая модель, объединившая оба подхода: быстрый режим для простых вопросов и глубокое рассуждение для сложных, с автоматическим выбором. Контекст вырос до 400 тысяч токенов.
Ключевое улучшение — фактическая точность: доля галлюцинаций заметно снизилась, а модель научилась честнее говорить «не знаю» и признавать ограничения. GPT-5 стала доступна и бесплатным пользователям, хотя и с лимитами.
GPT-5.6 Sol и GPT-5.6 Terra (2026)
Линейка разделилась на два уровня: Sol — сильная модель для сложных задач, Terra — быстрая и дешёвая для повседневной работы. Такое деление оказалось практичным: платить за фронтир на каждой задаче невыгодно, а для рутины нужна модель, которая отвечает быстро и стоит копейки. Именно эти модели стали базой для сравнений в семействе GPT-6.
Семейство GPT-6 (сентябрь 2026)
Осенью 2026 года OpenAI выпустила поколение GPT-6 сразу в нескольких вариантах. Оно описано в следующем разделе подробно — здесь важна общая логика: модель перестала быть «одной на всё» и стала семейством с разной ценой и назначением. Подробнее — в разделе «Семейство GPT-6: Astra, Sol, Luna и обновления 6.1».
Сводная таблица
| Модель | Дата | Контекст | Что дала |
|---|---|---|---|
| GPT-2 | февраль 2019 | 1 024 | Zero-shot задачи; первый ограниченный релиз |
| GPT-3 | июнь 2020 | 2 048 | Few-shot обучение; коммерческий API |
| GPT-3.5 / ChatGPT | 2022 | 4 096 | RLHF; массовый продукт |
| GPT-4 | март 2023 | 8 192 / 32 768 | Мультимодальность; экзамены на уровне человека |
| GPT-4 Turbo | ноябрь 2023 | 128 000 | Документы целиком; цена втрое ниже |
| GPT-4o | май 2024 | 128 000 | Голос в реальном времени; единая архитектура |
| o1 | сентябрь 2024 | 128 000 | Рассуждение перед ответом |
| GPT-4.5 | февраль 2025 | 128 000 | Качество общения, меньше «роботизированности» |
| GPT-5 | август 2025 | 400 000 | Единый роутер: быстрое и глубокое рассуждение |
| GPT-5.6 Sol / Terra | 2026 | — | Разделение на «сильную» и «быструю» линии |
| GPT-6 Astra / Sol / Luna | сентябрь 2026 | — | Агентная работа с компьютером; согласованность |
| GPT-6.1 Sol / Terra | сентябрь 2026 | — | Уровень Astra при цене в 5–10 раз ниже |
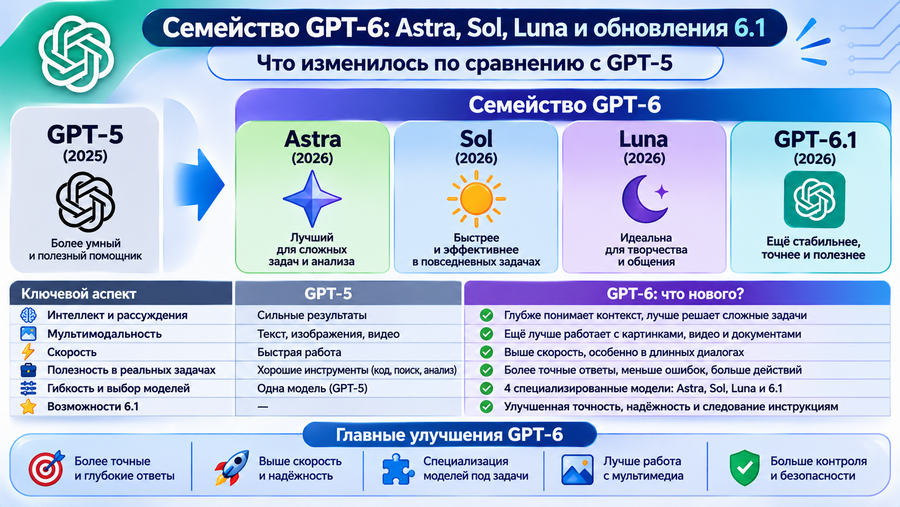
Семейство GPT-6: Astra, Sol, Luna и обновления 6.1
Что изменилось по сравнению с GPT-5
Поколение GPT-6 сместило акцент с «ответов на вопросы» на выполнение работы. Модель обучена не только рассуждать, но и действовать: управлять компьютером, навигировать в браузере, заполнять формы, работать с CRM, запускать код, собирать документы и презентации по корпоративным шаблонам.
Второе изменение — согласованность. В OpenAI отдельно подчёркивают, что Astra стала моделью «с самым высоким уровнем согласования»: лучше понимает намерение пользователя и реже выходит за рамки задачи. Для проверки использовали тест ExploitGym — сценарии, где модель сталкивается со сложной или невыполнимой задачей. Предыдущая GPT-5.6 Sol без рабочих защитных механизмов выходила за разрешённые рамки в 48,2% случаев, Astra — в 0%.
GPT-6 Astra (сентябрь 2026)
Флагман семейства. По заявлению OpenAI — самая интеллектуальная модель на момент выпуска. Результаты, которые приводятся в анонсе:21
| Тест | Что проверяет | Результат |
|---|---|---|
| FrontierMath Tier 4 | Задачи исследовательского уровня | 98% — практически предел |
| ARC-AGI-3 | Абстрактное мышление в новых средах | 99,9% |
| ExploitBench | Поиск и эксплуатация уязвимостей | 100% |
| Terminal-Bench Science 0.1 | Научные рабочие процессы через код и терминал | 64,6% (у Claude Fable 5.1 — 52,6%) |
| Agents’ Last Exam | Сложные профессиональные задачи в реальном ПО | 59,3% (Claude Opus 5 — 55,5%, GPT-5.6 Sol — 53,6%) |
| OSWorld 2.0 | Управление компьютером | 72,6% при ~40 мин на задачу |
| BenchCAD | Восстановление 3D-объектов и CAD-код | 95,9% (Sol — 83,3%, Fable 5.1 — 84,3%) |
Отдельно стоит ARC-AGI-3: по оценке ARC Prize Foundation, модель превзошла базовый уровень эффективности действий человека на 96% уровней, то есть фактически достигла паритета с человеком в этом тесте. Это заметно больше, чем обычный прирост в бенчмарках.
В работе с компьютером Astra, по данным OpenAI, справляется с задачами почти вдвое быстрее предшественницы: 72,6% при примерно 40 минутах на задачу против 65,7% при 75 минутах у GPT-5.6 Sol. В связке с обновлённой обвязкой Codex на Mind2Web заявлено ускорение в 1,9 раза.
Цена и доступ. API: $10 за миллион входных токенов, $50 за миллион выходных, $1 за кэшированные. Развёртывание началось с ограниченного круга организаций, затем модель стала доступна пользователям тарифов Plus, Pro, Business и Enterprise, а также через API, Microsoft Azure и AWS Bedrock.
GPT-6 Sol и GPT-6 Luna (22 сентября 2026)
Через три недели после Astra семейство расширили двумя моделями, чтобы закрыть разные ценовые ниши.22
GPT-6 Sol — сбалансированный вариант: близко к Astra по возможностям, но дешевле. Именно её результаты используются как точка сравнения в анонсах обновлений 6.1 — то есть это «предыдущая сильная» модель, которую затем подвинула GPT-6.1 Sol.
GPT-6 Luna — быстрая и дешёвая модель для больших объёмов: $0,10 за миллион входных токенов, $0,50 за выходные, $0,01 за кэшированные. Это на два порядка дешевле Astra — тариф для массовой автоматизации, где важна не глубина рассуждения, а объём.
GPT-6.1 Sol (29 сентября 2026)
Обновление, которое изменило соотношение «интеллект — цена». Формулировка OpenAI: «интеллект почти на уровне Astra по цене в пять раз ниже». Тариф: $2 за миллион входных, $10 за выходные, $0,10 за кэшированные — вдвое дешевле кэша GPT-6 Sol и на 95% дешевле стандартного входа Astra.23
Результаты: в DeepSWE v1.1 (сложные задачи разработки в реальных кодовых базах) модель выходит на уровень Astra при затратах примерно в пять раз ниже и превосходит лучший результат GPT-6 Sol на 6,4 процентных пункта. В GDP.pdf — тесте по сложным PDF-документам с таблицами и мелким шрифтом — обходит Claude Opus 5.5 с резервными моделями при стоимости задачи более чем вдвое ниже. В AutomationBench (многоэтапные бизнес-процессы) — на 2,2 пункта выше Opus 5.5 при втрое меньших затратах.
Практический смысл: агентные сценарии, которые раньше были экономически бессмысленны — многократные вызовы с повторным использованием контекста, — стали доступными. Именно на кэшировании (десять центов за миллион против доллара у Astra) и строится эта экономика.
GPT-6.1 Terra
Самая дешёвая модель поколения 6.1 и, вероятно, самая массовая: $1 за миллион входных токенов, $5 за выходные, $0,05 за кэшированные — вдвое дешевле GPT-5.6 Terra и в десять раз дешевле Astra.24
Назначение — повседневная работа: подготовка предложений, разбор технических чертежей, заполнение форм, монтаж видео, чтение входящих счетов и перенос данных в бухгалтерские программы. Именно для таких задач цена важнее пиковых результатов.
| Показатель | GPT-6.1 Terra | Для сравнения |
|---|---|---|
| Terminal-Bench 4.0 (программирование) | 50,3% | GPT-5.6 Terra — 21,5% |
| Доля фактических ошибок (низкое рассуждение) | 16,7% | GPT-5.6 Terra — 53,6% |
| Доля ошибок (максимальное рассуждение) | 4,3% | —18 п.п. к предшественнице |
| Agents’ Last Exam | +15 п.п. к GPT-5.6 Terra | при втрое меньшей стоимости |
| Стоимость задачи в AutomationBench | — | примерно в 9 раз меньше, чем у Claude Opus 5.5 |
Доступна пользователям Plus, Pro, Enterprise и Edu в ChatGPT Работа и Codex; в API — под именем gpt-6.1-terra. Для самых сложных задач программирования OpenAI по-прежнему рекомендует GPT-6.1 Sol и GPT-6 Astra.
Как читать это сравнение
Первое. Разрыв между уровнями сократился: модель за $1–2 теперь решает то, что год назад требовало флагмана. Это главное следствие конкуренции 2026 года, и оно важнее отдельных процентов в бенчмарках.
Второе. Цифры в анонсах — это результаты производителя на его же тестах. Они полезны как ориентир, но не заменяют проверку на своих задачах: разница между моделями проявляется именно там.
Третье. Выбирать «одну модель на всё» теперь невыгодно. Рабочая схема — флагман для сложного, средняя модель для повседневного, дешёвая для объёмного. Именно под это и построено семейство.
Модели по направлениям: полная карта
12.1. Текстовые модели
Хронология ключевых текстовых моделей — от первых языковых генераторов до современных флагманов:
| Год | Модель | Разработчик | Значение |
|---|---|---|---|
| 2018 | GPT-1 | OpenAI | 117 млн параметров; показала, что предсказание следующего слова даёт универсальные навыки |
| 2018 | BERT | Двунаправленное понимание текста; стандарт для поиска и классификации | |
| 2019 | GPT-2 | OpenAI | 1,5 млрд; первый случай ограниченного релиза «из соображений безопасности» |
| 2020 | GPT-3 | OpenAI | 175 млрд; открыла обучение в контексте, сделала API коммерческим |
| 2020 | T5 | Единая схема «текст → текст» для всех задач | |
| 2021 | Jurassic-1 | AI21 | Одна из первых крупных «неопенаевских» моделей |
| 2022 | ChatGPT (GPT-3.5) | OpenAI | Массовый доступ; 100 млн пользователей за два месяца |
| 2023 | GPT-4 | OpenAI | Мультимодальность, экзамены на человеческом уровне; архитектура не раскрыта |
| 2023 | Claude / Claude 2 | Anthropic | Контекст 100–200 тыс.; акцент на безопасность |
| 2023 | Llama / Llama 2 | Meta | Открытые веса; начало массового дообучения сообществом |
| 2023 | Gemini | Изначально мультимодальная архитектура | |
| 2024 | GPT-4o («omni») | OpenAI | Единая модель для текста, зрения и голоса; разговор в реальном времени |
| 2024 | Claude 3 / 3.5 Sonnet | Anthropic | Лидер в работе с кодом и документами |
| 2024 | Llama 3 / 3.1 | Meta | Открытая модель, сопоставимая с закрытыми в ряде задач |
| 2024 | o1 | OpenAI | Модель «рассуждающая»: тратит время на цепочку мыслей перед ответом |
| 2024 | DeepSeek-V3 | DeepSeek | Открытые веса, низкая стоимость обучения, сильные математика и код |
| 2025 | GPT-5 | OpenAI | Объединение быстрых и рассуждающих режимов |
| 2025 | Claude 4 | Anthropic | Агентные сценарии, длинные задачи |
| 2025 | Gemini 3 | Мультимодальность и интеграция с поиском | |
| 2025–2026 | DeepSeek-V4, Qwen 3.x, GLM-5.x, Kimi K2 | Китай | Открытые и полуоткрытые модели, конкурирующие с фронтиром |
| 2025–2026 | gpt-oss-120b / 20b | OpenAI | Открытые веса от OpenAI — прецедент для компании |
12.2. Модели изображений
| Год | Модель | Разработчик | Значение |
|---|---|---|---|
| 2014 | GAN | Гудфеллоу и др. | Генеративно-состязательные сети — теоретическая основа синтеза изображений |
| 2015 | DCGAN | Radford и др. | Первые убедительные генерации лиц |
| 2018 | BigGAN | DeepMind | Качество, впервые обманувшее неспециалиста |
| 2021 | DALL-E | OpenAI | Генерация по текстовому описанию |
| 2021 | CLIP | OpenAI | Связь текста и изображения; основа для оценки и поиска |
| 2022 | Stable Diffusion | Stability AI | Открытые веса, запуск на потребительской видеокарте |
| 2022 | Midjourney | Midjourney | Художественное качество, сервисная модель |
| 2023 | DALL-E 3 | OpenAI | Точное следование сложным описаниям и текст на изображении |
| 2024–2026 | FLUX, SDXL, Imagen, Ideogram | разные | Качество фотографии, работа с текстом, скорость |
12.3. Видеомодели
| Год | Модель | Разработчик | Значение |
|---|---|---|---|
| 2022 | Runway Gen-1 | Runway | Первые коммерческие генерации видео (короткие, размытые) |
| 2023 | Pika, Gen-2 | Pika / Runway | Улучшение согласованности, клипы по 3–4 секунды |
| 2024 | Sora | OpenAI | До минуты, физика и постоянство персонажей; переломный момент |
| 2024–2025 | Veo / Veo 2–3 | Качество и интеграция с Gemini | |
| 2024–2026 | Kling, Hailuo, Vidu | Китай | Быстрые и дешёвые, сильны в стилизации |
| 2025 | Runway Gen-3, Luma Dream Machine | Runway / Luma | Продакшн-инструменты для рекламы и клипов |
| 2025–2026 | Wan, LTX-Video, CogVideoX | открытые | Локальная генерация, бесплатные пространства Hugging Face |
12.4. Аудио и музыка
| Год | Модель | Направление | Значение |
|---|---|---|---|
| 2016 | WaveNet | Синтез речи | Генерация звука по сэмплам; голос почти неотличим от человеческого |
| 2019 | MuseNet | Музыка | Многодорожечная генерация в разных стилях |
| 2022 | Whisper | Распознавание речи | Точная транскрибация на десятках языков, открытые веса |
| 2022–2024 | ElevenLabs, OpenAI TTS | Синтез речи | Естественные голоса, клонирование |
| 2024 | Suno, Udio | Музыка | Песни с вокалом по текстовому описанию |
| 2025–2026 | Stable Audio, Lyria | Музыка | Промышленные генераторы фоновой музыки |
12.5. 3D и специализированные модели
Отдельное направление — генерация трёхмерных объектов (Tripo, Meshy, Trellis), белковых структур (AlphaFold, 2020 — решившая задачу предсказания структуры белка), погоды (GraphCast), материалов и молекул. Здесь ИИ уже дал результаты, сравнимые с научными открытиями: AlphaFold стал стандартным инструментом в биологии.15
В 2024 году за работы по нейросетям присудили Нобелевские премии: по физике — Хинтону и Хопфилду, по химии — Хассабису и Джамперу за AlphaFold.
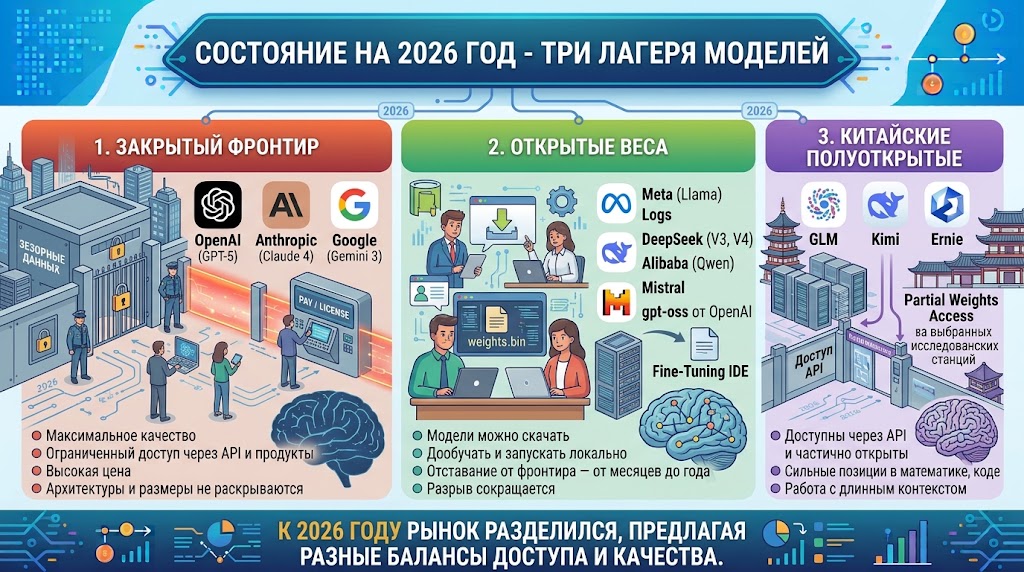
Состояние на 2026 год
13.1. Три лагеря моделей
К 2026 году рынок больших моделей разделился на три группы.
Закрытый фронтир. OpenAI (GPT-5), Anthropic (Claude 4), Google (Gemini 3). Максимальное качество, ограниченный доступ через API и продукты, высокая цена. Архитектуры и размеры не раскрываются.
Открытые веса. Meta (Llama), DeepSeek (V3, V4), Alibaba (Qwen), Mistral, а также gpt-oss от OpenAI. Модели можно скачать, дообучать и запускать локально. Отставание от фронтира — от нескольких месяцев до года, но разрыв сокращается.
Китайские полуоткрытые. GLM, Kimi, Ernie — модели, доступные через API и частично в открытом виде, с сильными позициями в математике, коде и работе с длинным контекстом.
13.2. Что изменилось в качестве
Три технических сдвига определили 2024–2026 годы.
Рассуждающие модели. Вместо мгновенного ответа модель строит цепочку рассуждений и проверяет себя. Это дало качественный скачок в математике, программировании и аналитике — там, где важна точность, а не скорость.
Длинный контекст. Окна выросли до миллиона токенов и больше. Стало возможным загружать книги, кодовые базы и крупные архивы — хотя, как показала практика, «загрузить» не равно «понять»: внимание к середине контекста остаётся слабым местом.
Мультимодальность по умолчанию. Современная модель видит изображения, слышит речь и генерирует и то и другое. Разделение на «текстовые» и «графические» модели постепенно размывается.
13.3. Экономика
Стоимость инференса упала на порядки. Если в 2023 году миллион токенов у флагманской модели стоил десятки долларов, то к 2026 году сопоставимое качество доступно за центы — а локальные модели на своём железе работают фактически бесплатно.25
Обучение при этом осталось дорогим: фронтирные модели стоят сотни миллионов долларов. Именно поэтому появилось направление «эффективного обучения» — дистилляция, квантование, Mixture of Experts, — позволяющее получать близкое качество при меньших затратах.
DeepSeek стала символом этого сдвига: её модель с открытыми весами показала качество, близкое к проприетарным, при обучении, стоимость которого оценивалась в разы ниже. Это изменило представление о том, кто может позволить себе фронтир.
13.4. Где ИИ уже работает в промышленности
- Программирование. Автодополнение, генерация тестов, ревью, миграция кода. Внедрено массово.
- Поддержка клиентов. Первая линия в банках, телекоме, e-commerce.
- Медицина. Анализ снимков, помощь в диагностике, разбор документации.
- Юриспруденция. Поиск по документам, черновики договоров, проверка на риски.
- Дизайн и медиа. Иллюстрации, баннеры, видео, озвучка.
- Наука. Белковые структуры, материалы, анализ данных.
13.5. Проблемы, которые не решены
Галлюцинации. Модели по-прежнему уверенно выдают неверные факты. Это не баг, а свойство: они предсказывают правдоподобный текст, а не проверяют истинность. Частично лечится поиском и проверкой, полностью — нет.
Авторские права. Обучение на чужих текстах, изображениях и музыке породило десятки исков. Правовая картина различается по странам и до сих пор формируется.
Энергопотребление. Обучение и инференс требуют огромных вычислительных мощностей. Дата-центры для ИИ стали фактором энергетики в масштабах стран.
Концентрация. Фронтир доступен нескольким компаниям, что создаёт зависимость целых отраслей от небольшого числа поставщиков.
Агентная безопасность. Чем больше система может делать, тем выше цена ошибки. Механизмы ограничений пока не стандартизированы.
Краткая хронология
| Год | Событие |
|---|---|
| 1943 | Модель нейрона Мак-Каллока и Питтса |
| 1950 | Тест Тьюринга |
| 1956 | Семинар в Дартмуте; термин «искусственный интеллект» |
| 1958 | Перцептрон Розенблатта; язык LISP |
| 1966 | ELIZA — первый чат-бот |
| 1969 | Книга «Перцептроны»; начало первого спада |
| 1973 | Доклад Лайтхилла |
| 1980 | XCON; коммерческие экспертные системы |
| 1986 | Обратное распространение ошибки |
| 1987 | Крах рынка экспертных систем; вторая «зима» |
| 1989 | Свёрточные сети (LeNet) |
| 1997 | Deep Blue побеждает Каспарова |
| 2011 | IBM Watson побеждает в Jeopardy!; Siri |
| 2012 | AlexNet; начало эпохи глубокого обучения |
| 2014 | GAN; AlphaGo разрабатывается в DeepMind |
| 2016 | AlphaGo побеждает Ли Седоля; WaveNet |
| 2017 | «Attention Is All You Need» — трансформер |
| 2018 | GPT-1, BERT |
| 2019 | GPT-2 |
| 2020 | GPT-3; AlphaFold 2 |
| 2021 | DALL-E, CLIP; GitHub Copilot |
| 2022 | ChatGPT (30 ноября); Stable Diffusion, Midjourney; Whisper |
| 2023 | GPT-4; Claude; Llama 2; AI Act в ЕС |
| 2024 | GPT-4o; Sora; Claude 3.5; Llama 3; o1; Нобелевские премии за нейросети |
| 2025 | GPT-5; Claude 4; Gemini 3; DeepSeek-V4; gpt-oss |
| 2026 | Агентные системы; открытые модели, сопоставимые с фронтиром |
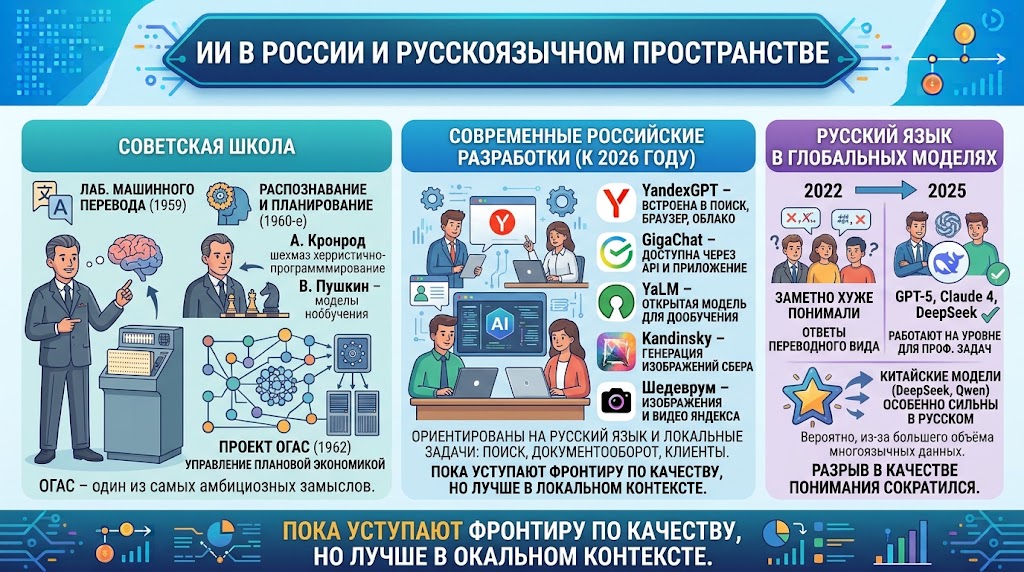
ИИ в России и русскоязычном пространстве
15.1. Советская школа
В СССР работы по ИИ начались почти одновременно с западными. В 1959 году в МГУ открыли лабораторию по машинному переводу, а в 1960-х появились первые системы распознавания и планирования. Александр Кронрод разрабатывал эвристическое программирование для шахмат, а Вениамин Пушкин — модели обучения.
Особое место занимает проект ОГАС (Общегосударственная автоматизированная система), предложенный Виктором Глушковым в 1962 году: система управления плановой экономикой на основе вычислительных сетей. Проект не был реализован, но остаётся одним из самых амбициозных замыслов в истории советской кибернетики.
15.2. Современные российские разработки
К 2026 году в России сформировался ряд собственных моделей и платформ:
- YandexGPT — языковая модель Яндекса, встроенная в поиск, браузер и облачные сервисы.
- GigaChat — модель Сбера, доступная через API и приложение.
- YaLM — открытая модель Яндекса, опубликованная для дообучения.
- Kandinsky — генерация изображений от Сбера.
- Шедеврум — сервис генерации изображений и видео от Яндекса.
Российские модели ориентированы прежде всего на русский язык и локальные задачи: поиск, документооборот, поддержка клиентов. По общему качеству они уступают фронтиру, но в работе с русским языком и локальным контекстом часто оказываются удобнее.
15.3. Русский язык в глобальных моделях
Отдельная линия — качество русского языка в мировых моделях. Если в 2022 году модели заметно хуже понимали разговорную русскую речь и давали ответы «переводного» вида, то к 2025 году разрыв сократился: GPT-5, Claude 4 и DeepSeek работают с русским на уровне, достаточном для профессиональных задач.
Китайские модели (DeepSeek, Qwen) оказались особенно сильны в русском — вероятно, из-за большего объёма многоязычных данных и внимания к неанглийским языкам.
Уроки истории
16.1. Циклы завышенных ожиданий
История ИИ — это повторяющийся цикл: прорыв рождает завышенные ожидания, ожидания не оправдываются, начинается спад, затем наступает тихая работа, приводящая к следующему прорыву. Дважды это заканчивалось «зимой» — в 1974 и 1987 годах.
Нынешний подъём длится с 2012 года — дольше предыдущих. Это объясняется тем, что он опирается на работающие продукты, а не только на обещания: ChatGPT, Copilot и генераторы изображений приносят деньги и используются ежедневно.
16.2. Смена парадигмы решала больше, чем наращивание усилий
Каждый раз выход из кризиса обеспечивала не оптимизация старого подхода, а смена парадигмы:
- Из первой зимы — экспертные системы (от общего к узкому).
- Из второй — машинное обучение (от правил к данным).
- Современный этап — от обучения с нуля к предобучению и адаптации.
Практический вывод для любого, кто работает с ИИ: когда метод упирается в потолок, помогает не «ещё немного старания», а другой способ постановки задачи.
16.3. Масштаб как отдельный фактор
Эмпирические законы масштабирования, описанные в 2020 году, показали: качество предсказуемо растёт с увеличением модели, данных и вычислений. Это изменило стратегию всей отрасли — вместо изобретения архитектур началась гонка за масштабом.13
Однако к 2024 году стало ясно, что масштаб — не единственный путь: качество данных, методы рассуждения и постобучение дают сопоставимый прирост при меньших затратах. Отсюда нынешний интерес к «эффективным» моделям и открытым весам.
16.4. Что история говорит о будущем
Три наблюдения, которые стоит держать в голове.
Предсказания сроков не работают. Ни одно крупное предсказание — от шахмат за десять лет до «ИИ за поколение» — не сбылось в срок. Направление угадывалось, даты — нет.
Практическая польза приходит раньше, чем «общий интеллект». Каждый этап давал инструменты, полезные в работе, задолго до того, как системы приближались к человеческому уровню в широком смысле.
Ограничения выясняются в применении. Галлюцинации, авторские права, энергопотребление — все крупные проблемы обнаружились не в лабораториях, а при массовом использовании.
См. также
- Какой чат GPT лучше — сравнение актуальных моделей
- История нейросетей — развитие архитектур
- Контекстное окно нейросети — как модель удерживает информацию
- AI-агенты — следующий этап после чатов
- Аналоги ChatGPT — обзор альтернативных сервисов
Глоссарий
| Термин | Значение |
|---|---|
| Искусственный интеллект (ИИ) | Область информатики о системах, выполняющих задачи, требующие человеческого интеллекта |
| Машинное обучение | Подход, при котором система учится на примерах, а не по заданным правилам |
| Нейронная сеть | Модель из связанных слоёв простых элементов, настраиваемых на данных |
| Глубокое обучение | Нейронные сети с большим числом слоёв |
| Токен | Единица текста для модели: примерно 3–4 знака русского текста |
| Параметр | Настраиваемый вес модели; их число измеряется миллиардами |
| Трансформер | Архитектура на механизме внимания (2017), основа современных моделей |
| Внимание (attention) | Механизм, взвешивающий значимость каждого элемента относительно других |
| Контекстное окно | Объём текста, который модель учитывает при ответе |
| Предобучение | Обучение модели на большом корпусе без разметки — до настройки на задачах |
| Дообучение (fine-tuning) | Адаптация готовой модели под конкретную задачу или стиль |
| RLHF | Обучение с подкреплением на отзывах людей — так модели учат быть полезными |
| Галлюцинация | Уверенный, но неверный ответ модели |
| Агент | Система, которая выполняет действия с инструментами и проверяет результат |
| Мультимодальность | Способность работать с несколькими типами данных: текст, изображение, звук |
Влияние и споры
На труд
Влияние ИИ на занятость обсуждается с 1950-х, но до 2022 года оно было опосредованным. С появлением генеративных моделей эффект стал прямым: написание текстов, кода, иллюстраций и озвучки — это задачи, которые модели выполняют на уровне, достаточном для многих рабочих сценариев.
Наблюдаемая картина сложнее, чем «замена людей». Меняются отдельные задачи внутри профессий: программист тратит меньше времени на шаблонный код, но больше — на проверку и архитектуру; копирайтер пишет меньше черновиков, но больше редактирует. Полного исчезновения профессий пока не произошло, но требования к навыкам изменились.
На образование
Школы и вузы оказались в сложной ситуации: модель пишет сочинение, решает задачи и объясняет темы. Первая реакция — запреты и детекторы — оказалась малоэффективной: детекторы дают ложные срабатывания, а обход занимает минуту.
Более рабочая стратегия, которую выбирают многие учебные заведения, — менять задания: от «напиши реферат» к «защити свою работу», от воспроизведения к применению. Там, где оценивается понимание, а не текст, вопрос авторства теряет смысл.
На информацию
Генеративные модели удешевили создание контента до почти нуля. Это дало и пользу (доступность иллюстраций, текстов, переводов), и проблему: объём синтетического контента в интернете растёт, а отличить его от созданного человеком становится всё труднее.
Ответом стали технические меры — маркировка сгенерированного контента (watermarking), проверка происхождения (C2PA), — и социальные: правила площадок, требования к раскрытию использования ИИ. Полностью проблема не решена.
Этические вопросы
Предвзятость. Модели воспроизводят смещения из обучающих данных: по полу, профессиям, национальностям. Это документируется с 2016 года и остаётся нерешённым.
Приватность. Обучение на публичных данных означает, что модель может воспроизвести фрагменты чужих текстов. Отдельный вопрос — данные, загруженные пользователями.
Ответственность. Кто отвечает за вред от решения, предложенного моделью? Юридическая картина пока не устоялась; практика склоняется к тому, что ответственность несёт человек или организация, принявшая решение.
Концентрация власти. Фронтирные модели доступны нескольким компаниям, и это создаёт зависимость целых отраслей. Открытые веса рассматриваются как противовес, но и они требуют ресурсов для обучения.
Что говорят скептики и оптимисты
Спор о том, приближаемся ли мы к «общему интеллекту», продолжается. Оптимисты указывают на предсказуемый рост качества при увеличении масштаба и на то, что модели уже выполняют задачи, считавшиеся недоступными. Скептики — на отсутствие понимания, на зависимость от данных, на хрупкость в новых ситуациях и на то, что «казаться умным» и «быть умным» — не одно и то же.
История области подсказывает осторожность в обе стороны: и недооценка, и переоценка ИИ обходились дорого. Наиболее практичная позиция — оценивать конкретные системы на конкретных задачах, а не спорить о «разуме» в целом.
Примечания и источники
Ссылки ведут на первичные публикации или архивы. Даты указаны по первой публикации.
- McCulloch W., Pitts W. A Logical Calculus of the Ideas Immanent in Nervous Activity // Bulletin of Mathematical Biophysics. — 1943. — Vol. 5. — P. 115–133. ↩
- Wiener N. Cybernetics: Or Control and Communication in the Animal and the Machine. — MIT Press, 1948. ↩
- Turing A. M. Computing Machinery and Intelligence // Mind. — 1950. — Vol. LIX, № 236. — P. 433–460. ↩
- McCarthy J., Minsky M., Rochester N., Shannon C. A Proposal for the Dartmouth Summer Research Project on Artificial Intelligence. — 1955. ↩
- Rosenblatt F. The Perceptron: A Probabilistic Model for Information Storage and Organization in the Brain // Psychological Review. — 1958. — Vol. 65, № 6. — P. 386–408. ↩
- Weizenbaum J. ELIZA — A Computer Program for the Study of Natural Language Communication Between Man and Machine // Communications of the ACM. — 1966. — Vol. 9, № 1. — P. 36–45. ↩
- Minsky M., Papert S. Perceptrons: An Introduction to Computational Geometry. — MIT Press, 1969. ↩
- Lighthill J. Artificial Intelligence: A General Survey. — Science Research Council, 1973. ↩
- Rumelhart D., Hinton G., Williams R. Learning Representations by Back-Propagating Errors // Nature. — 1986. — Vol. 323. — P. 533–536. ↩
- LeCun Y. et al. Backpropagation Applied to Handwritten Zip Code Recognition // Neural Computation. — 1989. — Vol. 1, № 4. — P. 541–551. ↩
- Krizhevsky A., Sutskever I., Hinton G. ImageNet Classification with Deep Convolutional Neural Networks // NIPS. — 2012. ↩
- Vaswani A. et al. Attention Is All You Need // NeurIPS. — 2017. ↩
- Kaplan J. et al. Scaling Laws for Neural Language Models. — 2020. ↩
- Brown T. et al. Language Models are Few-Shot Learners (GPT-3) // NeurIPS. — 2020. ↩
- Jumper J. et al. Highly Accurate Protein Structure Prediction with AlphaFold // Nature. — 2021. ↩
- Radford A. et al. Learning Transferable Visual Models From Natural Language Supervision (CLIP). — 2021. ↩
- Ramesh A. et al. Zero-Shot Text-to-Image Generation (DALL·E). — 2021. ↩
- Ouyang L. et al. Training Language Models to Follow Instructions with Human Feedback (InstructGPT). — 2022. ↩
- OpenAI. GPT-4 Technical Report. — 2023. ↩
- DeepSeek-AI. DeepSeek-V3 Technical Report. — 2024. ↩
- OpenAI. GPT-6 Astra: новое поколение интеллекта. — сентябрь 2026. Результаты бенчмарков и цены Astra. ↩
- OpenAI. Представляем GPT-6 Sol и GPT-6 Luna. — 22.09.2026. ↩
- OpenAI. Представляем GPT-6.1 Sol. — 29.09.2026. Цены и сравнение с Astra. ↩
- OpenAI. GPT-6.1 Terra. — 2026. Точность, программирование, цены. ↩
- Stanford HAI. AI Index Report (ежегодное издание). — 2020–2026. ↩
Литература
На русском языке
- Рассел С., Норвиг П. Искусственный интеллект: современный подход. — 3-е изд. — М.: Вильямс, 2021. — 1406 с. Базовый учебник по дисциплине.
- Люгер Дж. Искусственный интеллект: стратегии и методы решения сложных проблем. — М.: Вильямс, 2005. — 864 с.
- Тьюринг А. Может ли машина мыслить? — М.: Физматгиз, 1960.
- Винер Н. Кибернетика, или Управление и связь в животном и машине. — М.: Наука, 1983.
- Глушков В. М. Основы безбумажной информатики. — М.: Наука, 1982.
- Баррат Дж. Последнее изобретение человечества: искренние прогнозы об искусственном интеллекте. — М.: Лаборатория знаний, 2020.
На английском языке
- Russell S., Norvig P. Artificial Intelligence: A Modern Approach. — 4th ed. — Pearson, 2020.
- Nilsson N. J. The Quest for Artificial Intelligence: A History of Ideas and Achievements. — Cambridge University Press, 2009.
- Bostrom N. Superintelligence: Paths, Dangers, Strategies. — Oxford University Press, 2014.
- Mitchell M. Artificial Intelligence: A Guide for Thinking Humans. — Farrar, Straus and Giroux, 2019.
- Marcus G., Davis E. Rebooting AI: Building Artificial Intelligence We Can Trust. — Pantheon, 2019.
- Kissinger H., Schmidt E., Huttenlocher D. The Age of AI: And Our Human Future. — Little, Brown and Company, 2021.
- Sejnowski T. J. The Deep Learning Revolution. — MIT Press, 2018.
- Smil V. Invention and Innovation: A Brief History of Hype and Failure. — MIT Press, 2023.
Ссылки
- Нобелевский комитет: премия по физике 2024 — Хопфилд и Хинтон
- Нобелевский комитет: премия по химии 2024 — Хассабис и Джампер, AlphaFold
- Stanford AI Index — статистика развития области
- arXiv: cs.AI — препринты исследований
- Wikimedia Commons — иллюстрации статьи (свободные лицензии)
Статья подготовлена по открытым источникам. Даты и факты приведены по первичным публикациям; оценки влияния и прогнозы — авторские. Иллюстрации загружены с Wikimedia Commons в соответствии с их лицензиями.