Контекстное окно — одна из тех характеристик, которые влияют на работу сильнее, чем кажется. От неё зависит, сколько текста модель удержит в голове одновременно: одну страницу или целую книгу.
Разберём, что это и как выбрать.
Что это такое
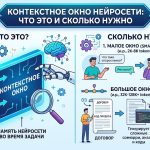
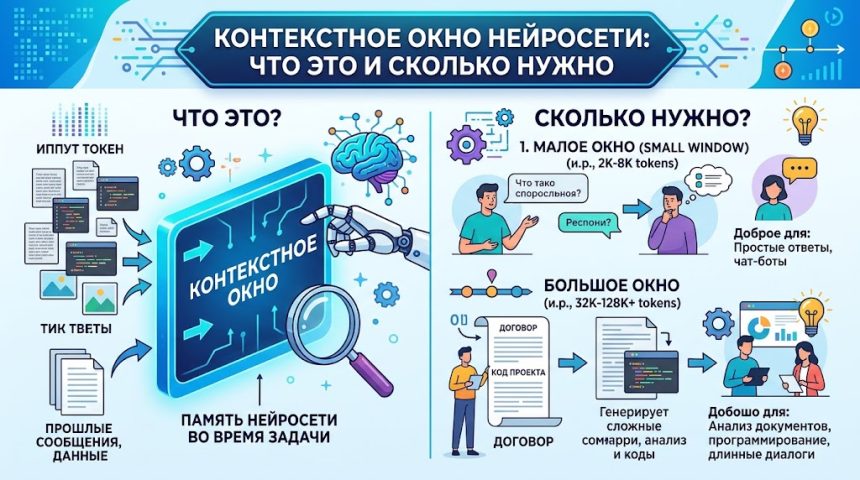
Контекстное окно — объём информации, который модель «видит» в момент ответа. В него входит всё: ваши сообщения, её ответы, загруженные файлы, инструкции. Когда окно заполняется, самое старое начинает теряться.
Измеряется в токенах. Токен — примерно 3–4 знака русского текста. Значит, окно в 32 000 токенов — это около 80–100 тысяч знаков, то есть примерно 40–50 страниц текста.
| Окно | Примерно знаков | Что влезает |
|---|---|---|
| 8 000 токенов | ~24 000 | Статья среднего размера |
| 32 000 | ~96 000 | Несколько статей, глава книги |
| 128 000 | ~380 000 | Большая книга, комплект документов |
| 1 000 000 | ~3 000 000 | Несколько книг, крупный архив |
Почему размер не главное
Большое окно не означает, что модель одинаково хорошо работает со всем содержимым. Есть важный нюанс: внимание распределяется неравномерно.
Лучше всего модель помнит начало и конец контекста. Середина большого окна — «мёртвая зона»: информация там остаётся формально, но может не повлиять на ответ. Поэтому «загрузил всю книгу» не равно «модель её прочитала».
Практический вывод: если нужен точный ответ по большому документу, разбивайте работу на части, а не полагайтесь на размер окна.
Сколько нужно на практике
| Задача | Достаточно |
|---|---|
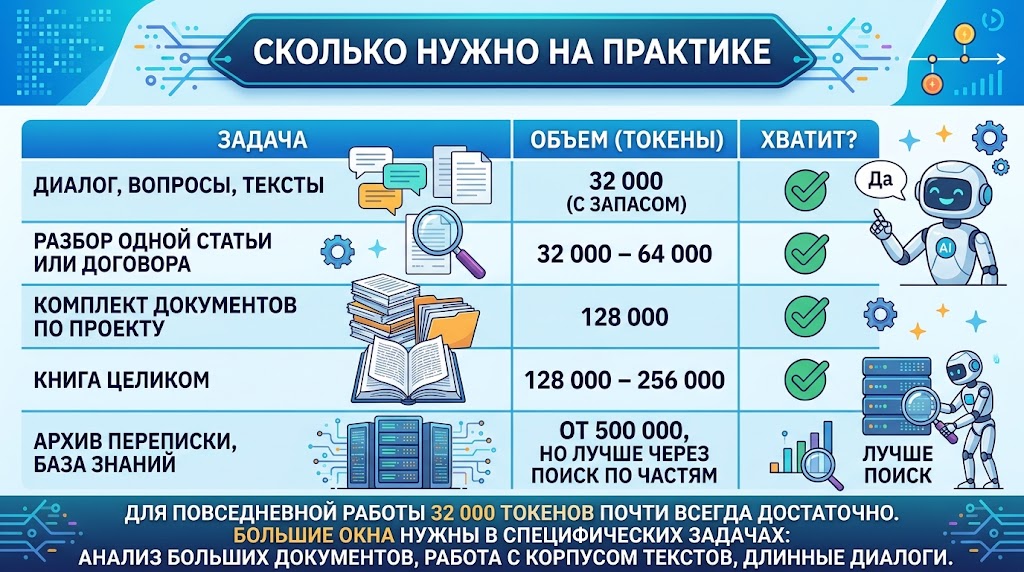
| Диалог, вопросы, тексты | 32 000 токенов с запасом |
| Разбор одной статьи или договора | 32 000–64 000 |
| Комплект документов по проекту | 128 000 |
| Книга целиком | 128 000–256 000 |
| Архив переписки, база знаний | от 500 000, но лучше через поиск по частям |
Для повседневной работы 32 000 токенов почти всегда достаточно. Большие окна нужны в специфических задачах: анализ больших документов, работа с корпусом текстов, длинные диалоги.
Как экономить контекст
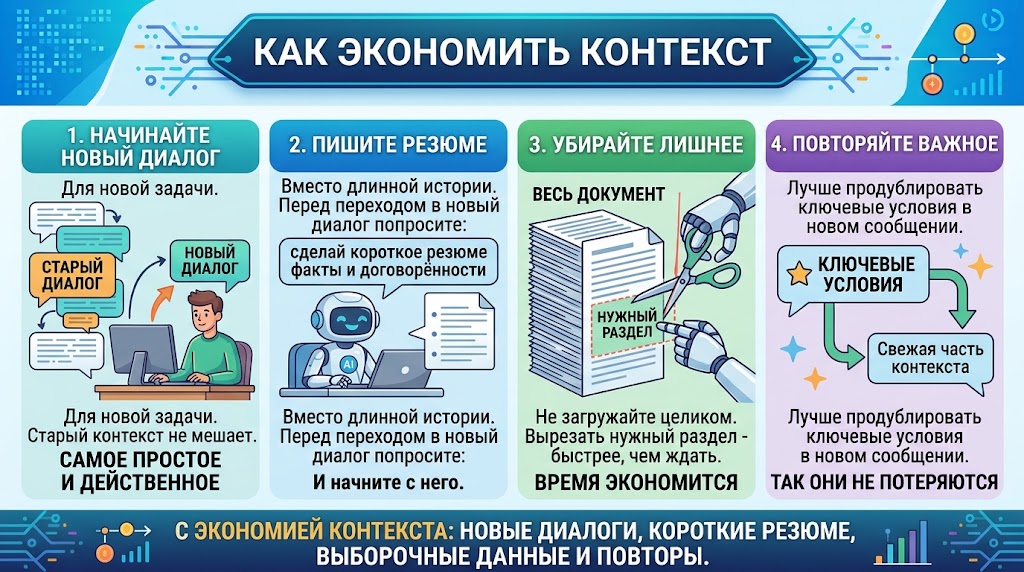
Начинайте новый диалог для новой задачи. Это самое простое и самое действенное: старый контекст не мешает.
Пишите резюме вместо истории. Перед переходом в новый диалог попросите «сделай короткое резюме разговора: факты и договорённости» — и начните с него.
Убирайте лишнее. Не загружайте документ целиком, если нужен один раздел. Вырезать нужное — быстрее, чем ждать разбора всего.
Повторяйте важное. Ключевые условия лучше продублировать в новом сообщении: так они попадут в «свежую» часть контекста.
Пример: как разбить большую задачу
Допустим, нужно разобрать договор на 60 страниц и найти риски. Плохой путь — загрузить всё и попросить «найди риски». В окно влезет, но середина документа выпадет из внимания.
Рабочий путь:
- Оглавление. «Вот оглавление документа. Скажи, какие разделы обычно содержат риски для заказчика».
- По разделам. Каждый раздел — отдельным запросом: «вот раздел про ответственность, найди условия, которые невыгодны мне».
- Сводка. «Вот мои заметки по разделам. Собери список рисков по убыванию важности».
Три шага вместо одного запроса, но результат точнее: каждый раздел разобран в «свежей» части контекста, где модель работает лучше всего.
То же с книгами и большими отчётами: сначала структура, потом главы, потом сборка. Это правило важнее размера окна — и работает в любой модели.
Что будет, если игнорировать контекст
Типичные симптомы переполнения: модель начинает переспрашивать то, что вы уже говорили; путает имена и условия; отвечает не на тот вопрос, который задан последним.
Лечится не «попросить вспомнить», а новым диалогом с резюме. Это занимает минуту и возвращает точность, которую уже не восстановить в перегруженном контексте.
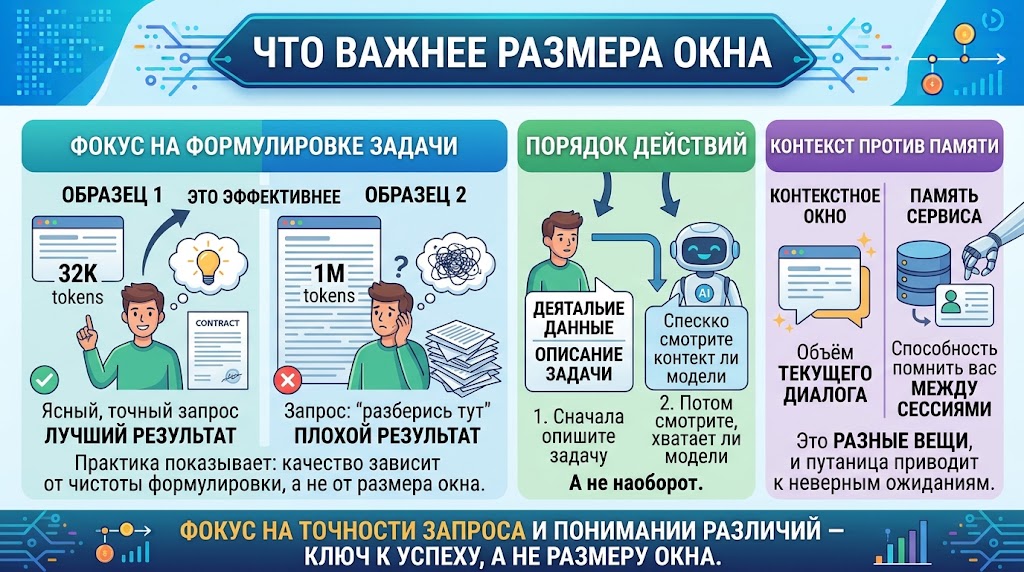
Что важнее размера окна
Практика показывает: качество ответа зависит не от размера окна, а от того, насколько чисто сформулирована задача. Модель с окном 32 000 и точным запросом даст лучший результат, чем модель на миллион токенов с запросом «разберись тут».
Поэтому порядок такой: сначала опишите задачу и данные, потом смотрите, хватает ли выбранной модели. А не наоборот.
И последнее: не путайте контекстное окно с памятью. Первое — это объём текущего диалога, вторая — способность сервиса помнить вас между сессиями. Это разные вещи, и путаница приводит к неверным ожиданиям.
Частые вопросы
Что будет, когда контекст закончится?
Модель начнёт терять начало разговора. Обычно это заметно по ответам: она переспрашивает то, что вы уже говорили.
Токен — это слово?
Примерно. В русском тексте один токен — это 3–4 знака, то есть слово часто делится на два токена.
Чем больше окно, тем лучше модель?
Нет. Это разные характеристики: окно — сколько помещается, качество — насколько хорошо модель понимает. Модель с большим окном может быть слабее в рассуждениях.
Почему модель забывает середину документа?
Так устроено внимание: начало и конец получают больше веса. Середина большого контекста может «выпасть».
Можно ли загрузить книгу целиком?
Технически да, если позволяет окно. Практически — лучше разбивать на главы: так ответы точнее.
Как понять, что контекст пора обновить?
Модель начала путать детали или повторять ранее сказанное. Знак простой: сделайте резюме и начните заново.
О том, как вести длинную работу — в статье чат с нейросетью. О выборе модели — в статье какой чат GPT лучше.